
Bachelor behaald · 2011
Management, Economie en Recht
Hogeschool van Amsterdam · Bachelor of Business Administration
Afgestudeerd met een eindcijfer 9. De minor Praktische filosofie sloot ik af met een eindcijfer 8.
Welkom op mijn website
Welkom in mijn testportfolio. Hier maak ik mijn werk als softwaretester tastbaar met interactieve demo’s, geautomatiseerde controles en uitleg over de techniek erachter. Ontdek wat ik bouw, hoe ik test en wat ik onderweg leer.
Even voorstellen
Deze openbare HTML-editie is een momentopname van mijn volledige testportfolio. Beschrijvingen van NAS-hosting, beheer en automatisering hieronder gaan over de opgebouwde omgeving; de openbare NAS-hosting is op 21 oktober 2026 gestopt.
Deze website is mijn online presentatie en praktische leeromgeving voor softwaretesten. Ik experimenteer met frontendontwikkeling, API’s en testautomatisering en ontwikkelde de volledige site op mijn eigen NAS. Deze statische editie wordt extern gehost. Mijn ervaring als Test Engineer en Test Automation Specialist vormt de basis; met de projecten laat ik mijn aanpak en technische ontwikkeling zien.
Deze website is ook mijn testportfolio. Met interactieve demo’s laat ik zien hoe ik als softwaretester risico’s onderzoek, testscenario’s uitwerk en controles automatiseer — zowel via de gebruikersinterface als rechtstreeks via API’s. Ik maak daarbij mijn aanpak en afwegingen zichtbaar. De site blijft zich ontwikkelen: ik bouw, test, verbeter en controleer of alles blijft werken.
De volledige versie bevat ook een privéportaal voor testbewaking en beheer. Dat portaal is niet opgenomen in deze openbare HTML-editie.
Ook wijzigingen aan deze site doorlopen een vast publicatieproces. Ik bewaar de code lokaal in Git en voer vóór publicatie automatische controles uit. Alleen als die slagen, ontstaat een testbewijs dat de softwareversie koppelt aan de geselecteerde bestanden. Met SHA-256-vingerafdrukken controleert het publicatiescript of die bestanden ongewijzigd zijn en correct op mijn server terechtkomen. Zonder passend testbewijs wordt de publicatie geblokkeerd. Na publicatie controleer ik automatisch of de online homepage overeenkomt met de verwachte versie en of belangrijke onderdelen aanwezig zijn. Het resultaat wordt als testbewijs bewaard.
De indeling helpt je gericht rond te kijken: maak kennis met mijn achtergrond, verken de testprojecten en verdiep je in de blog, leerdoelen en vakgerichte events. Via het berichtenformulier kun je een vraag stellen of een idee voor een testdemo delen.
Professioneel
Ik werk al meer dan vijftien jaar in de IT. Vanuit technische ondersteuning en operations ontwikkelde ik me tot Test Engineer en Test Automation Specialist. Ik onderzoek het gedrag van software, automatiseer controles en help de kwaliteit te verbeteren. Op deze website laat ik mijn aanpak zien met interactieve demo’s en geautomatiseerde tests.
Kennis en ontwikkeling
Deze elf certificaten ondersteunen mijn kennis van softwaretesten, testautomatisering en aanverwante vakgebieden. Ze zijn hieronder gegroepeerd naar onderwerp. Klik op een certificaat om het als PDF in een nieuw tabblad te bekijken.
Mijn opleiding
Mijn opleidingsachtergrond, met de bacheloropleiding als belangrijkste mijlpaal.
Bachelor behaald · 2011
Hogeschool van Amsterdam · Bachelor of Business Administration
Afgestudeerd met een eindcijfer 9. De minor Praktische filosofie sloot ik af met een eindcijfer 8.
Propedeuse behaald · 2003
Hogeschool van Amsterdam
Diploma behaald · 2001
Christelijke Scholengemeenschap Buitenveldert
Mijn diploma’s zijn op verzoek beschikbaar voor verificatie of een sollicitatieprocedure.
Projectarchief · uitleg en eerder vastgelegde resultaten. De interactieve toepassingen en actuele status worden hier niet uitgevoerd.
Zelf gebouwd
Hier presenteer ik de demo’s die ik voor mijn volledige testportfolio heb gebouwd. De projecten laten zien hoe ik gebruikersinterfaces en API’s onderzoek en geautomatiseerd controleer. Deze website werkt zonder database. De projecten zijn gegroepeerd naar testdiscipline; toekomstige demo’s kunnen een eigen testomgeving krijgen.
Wat gebeurt er wanneer je op deze website een bericht verstuurt? Volg de vier stappen met fictieve voorbeeldgegevens. Deze uitleg voert geen aanvraag uit en slaat niets op.
De bediening
De browser toont het formulier. De naam is optioneel; de berichttekst is verplicht. JavaScript leest de invoer en geeft het bericht een unieke ID. Met diezelfde ID kan een herhaalde aanvraag worden herkend.
Wat test ik? Kan ik zonder naam versturen? Wordt een leeg bericht tegengehouden? Krijg ik een duidelijke melding als versturen niet lukt?
Voorbeeld: naam: Demo-bezoeker · bericht: “Een leuke suggestie voor een testdemo!”
Ook mijn testportfolio wordt automatisch gecontroleerd. Ik verzamel de testresultaten en houd bij of de geplande tests worden uitgevoerd. Het briefje hieronder toont de status van de Testbewaking ↓ lees je hoe de controles van de website en de NAW-service werken. In mijn afgeschermde beheerportaal bekijk ik de testhistorie en controleer ik of nieuwe resultaten op tijd binnenkomen.
Hier laat ik zien hoe ik geautomatiseerde tests uitvoer, resultaten vastleg en geplande uitvoeringen bewaak. De twee projecten controleren verschillende onderdelen:
Dit project wordt hier toegelicht. De interactieve demo, API en actuele testresultaten zijn niet actief in deze statische versie.
Wat wordt gecontroleerd? De gebruikersinterface van deze website wordt met Robot Framework in een echte browser gecontroleerd.
Waar staan de resultaten? Bekijk het laatste rapport, de teststappen en het downloadbare Robot-bestand.
Hoe wordt het uitgevoerd? Windows Taakplanner start de tests vanaf mijn laptop; rapporten worden op de NAS bewaard.
Ik voer de Robot Framework-tests uit vanaf mijn laptop om de frontend van mijn website te controleren. De Browser-bibliotheek stuurt daarvoor een echte browser aan; de browser kan zonder zichtbaar venster draaien. Windows Taakplanner start de tests automatisch vanaf mijn laptop.
De resultaten worden rechtstreeks op mijn NAS opgeslagen in results/frontend. Het rapport geeft het overzicht, het log toont de teststappen en output.xml bevat de resultaten voor verdere verwerking, bijvoorbeeld in CI/CD.
Dit project wordt hier toegelicht. De interactieve demo, API en actuele testresultaten zijn niet actief in deze statische versie.
Wat wordt gecontroleerd? Vijf NAW-records: HTTP-status, geldige XML en de verwachte gegevens.
Waar staan de resultaten? Bekijk de laatste testresultaten en de gegenereerde HTML-, JSON- en JUnit-rapporten.
Hoe wordt het uitgevoerd? Een uurlijkse NAS-taak voert de HTTP-controles uit en maakt rapportbestanden.
Deze runner controleert de vijf NAW-records via echte HTTP GET-verzoeken: status 200, geldige XML en de verwachte namen en adressen. Een geplande taak op mijn NAS kan hem ieder uur starten, ook als niemand de website bezoekt. Zo wordt zichtbaar of de testservice blijft werken.
Iedere uitvoering maakt een HTML-rapport, JSON-data en een JUnit XML-rapport in results. CI/CD kan het JUnit-rapport verwerken en de bestanden als artifacts bewaren. De runner geeft een foutcode bij mislukte tests, zodat een pipeline daarop kan reageren.
De uurlijkse planning wordt op de NAS ingesteld; het rapport hieronder toont de laatste werkelijk uitgevoerde controle.
Doel: als beheerder wil ik weten of tests worden uitgevoerd en welke resultaten ze opleveren.
Werking: de laptop en NAS voeren tests uit; een verzameltaak verwerkt rapporten; het portaal toont historie en vergelijkt ontvangen resultaten met de verwachte planning.
Bij een afwijking: ik onderzoek rapporten en meldingen en controleer na herstel een nieuwe uitvoering.
Wat dit demonstreert: de verbinding tussen gebruikersdoel, ontwerp, acceptatiecriteria, testen en beheer.
Het openbare briefje vat ontvangen testresultaten over de gekozen periode samen; mijn privéportaal bewaakt daarnaast de planning. Het briefje bewijst dus niet zelfstandig dat iedere geplande uitvoering heeft plaatsgevonden.
Onderzoek de bediening van een webapp en ontdek hoe je frontendcontroles herhaalbaar maakt.
Dit project wordt hier toegelicht. De interactieve demo, API en actuele testresultaten zijn niet actief in deze statische versie.
Wat laat het zien? Frontendtesten met drie rollen en een gedeelde API voor één dobbelsteen.
In de volledige demo: Speel, onderzoek demo-bugs of voer browserchecks uit als Test Automation Engineer.
Wat leer je ervan? Het verschil tussen handmatig testen, regressiechecks en gerichte API-tests.
Deze dobbelsteenapp is een kleine testomgeving met drie fictieve rollen.
Als Speler kies je een spel en gooi je de dobbelstenen.
Als Software Tester (Handmatig / Functioneel) onderzoek je het gedrag, probeer je grenswaarden en onverwachte invoer en stel je kritische vragen over het ontwerp. De uitleg en speurhint helpen je om bewust ingebouwde bugs te ontdekken.
Sommige invoer brengt het spel van slag: het blijft snel dobbelen met wisselende aantallen dobbelstenen. Bij één van de bugs verschijnt na tien seconden een felicitatie met een stopknop. Er is ook een verborgen variant waarvoor je de pagina moet verversen. De precieze triggers mag je zelf uitzoeken.
Als Test Automation Engineer kun je negen spelcontroles met één klik uitvoeren in de browser die al openstaat. JavaScript bedient het spel, controleert de uitkomsten en toont de resultaten met een korte pauze tussen de testgevallen.
Het Robot Framework-bestand kun je bekijken en downloaden om de tests vanaf je eigen computer in een echte browser uit te voeren.
Alleen als Test Automation Engineer vraagt het spel bij Gewone dobbelsteen · 1 de worp op bij de PHP-API; de overige standen werken in de browser.
In iedere gewone spelstand rollen de dobbelstenen drie seconden voordat de definitieve ogen en getallen verschijnen. De bewust ingebouwde demo-bugs blijven snel achter elkaar dobbelen. De browserchecks wachten op die uitkomst.
Gerichte API-tests slaan deze presentatie over en controleren de zes mogelijke waarden rechtstreeks: sneller en voorspelbaar, terwijl een aanvullende frontendtest de weergave controleert.
Deze regressietests controleren de gewone spelfuncties; de bewust ingebouwde bugs bij de handmatige testrol vallen daar niet onder.
Een ontdekte demo-bug wordt op de achtergrond via een HTTP-verzoek naar een PHP-script gestuurd. Dat bewaart de gebeurtenis als XML op mijn NAS. Zo komen spelen, testen en foutregistratie samen, zonder database.
De foutgeschiedenis is alleen zichtbaar in mijn eigen portaal na inloggen.
Van risico naar controle
Deze casus gebruikt de bewust ingebouwde bug uit het dobbelspel. Het exacte speciale teken blijft geheim, zodat je de fout zelf kunt onderzoeken. De voorgestelde oplossing en regressietests zijn een vervolgstap; de demo-bug is hier expres niet gerepareerd.
Bij Zelf aantal kiezen verwacht het spel een geheel getal van 1 tot en met 100. In de handmatige testrol is het invoerveld een tekstveld. Dat is niet automatisch fout, maar betekent wel dat de applicatie zelf consequent moet valideren. Onverwachte invoer kan anders een ongewenste uitvoeringsroute activeren.
Prioriteit: geef dit risico in deze demo extra aandacht: vrije invoer is makkelijk te proberen en de bijwerking is zichtbaar en ingrijpend. Zonder gebruiksgegevens kennen we de werkelijke kans niet; dit is een kwalitatieve risicoafweging.
Begin met 1, een waarde midden in het bereik en 100. Probeer daarna 0, 101, een leeg veld, een decimaal, letters en speciale tekens. Controleer zowel de validatiemelding als de toestand van het spel.
Verwacht: geldige invoer levert precies het gekozen aantal dobbelstenen op. Ongeldige invoer wordt afgewezen en start geen nieuwe worp of achtergrondlus. Een eventueel bestaande worp hoeft daarbij niet te verdwijnen.
Een speciaal teken activeert continu dobbelen met wisselende aantallen. Het spel voert dus een actie uit terwijl de invoer volgens het gewone contract ongeldig is. Alleen controleren dat een foutmelding verschijnt, zou deze ongewenste bijwerking kunnen missen.
Een bruikbaar bugrapport bevat: de gekozen rol en spelstand, de exacte invoer, reproduceerbare stappen, verwacht en werkelijk gedrag en bijvoorbeeld een korte schermopname. Het exacte teken hoort in een werkelijk bugrapport, ook al verklappen we het hier niet.
Laat alle gewone invoer door dezelfde validatie gaan vóór een worp start. Accepteer uitsluitend gehele getallen binnen het afgesproken bereik en zorg dat ongeldige invoer geen actie activeert. Bespreek ook of een numeriek veld de bediening duidelijker maakt; zo’n veld vervangt de controle in de applicatie niet.
Na een echte reparatie automatiseer je de gevonden invoer en andere representatieve ongeldige waarden. Assert niet alleen de melding, maar ook dat er geen nieuwe worp of voortdurende activiteit ontstaat. Controleer daarnaast dat 1 en 100 nog correct werken. Omdat het gewone spel drie seconden animeert, wacht je bij geldige invoer op de definitieve toestand.
Huidige status: dit zijn voorgestelde regressietests. De bestaande browserchecks controleren gewone spelfuncties; ze bewijzen niet dat deze bewust ingebouwde bug is opgelost.
Mijn afweging: combineer grenswaarden en onverwachte invoer met controles op bijwerkingen. Een goede test kijkt niet alleen naar wat op het scherm verschijnt, maar ook of het systeem zich verder gedraagt zoals afgesproken.
Probeer XML- en JSON-services, controleer HTTP-responses en scheid testdata van testlogica.
Dit project wordt hier toegelicht. De interactieve demo, API en actuele testresultaten zijn niet actief in deze statische versie.
Wat laat het zien? Een XML-testservice met vijf vaste fictieve NAW-records en een XSD-schema.
In de volledige demo: Vraag een record op of controleer de service met browserchecks, Robot, Postman en cURL.
Wat leer je ervan? Het verschil tussen testen via de gebruikersinterface en rechtstreeks via HTTP.
Een kleine testservice met vijf fictieve NAW-records. Kies een record; de site haalt het bijbehorende XML-bestand via HTTP op van mijn server.
Een stub is een eenvoudige vervanger van een echte service: hij geeft vooraf bepaalde testdata terug. Deze NAW-stub levert vijf vaste XML-responses, zonder database of echte persoonsgegevens. Zo kun je voorspelbaar testen, ook als de echte service nog niet beschikbaar is.
Deze demo laat drie testaanpakken zien: cURL toont de basis — een HTTP-verzoek versturen en de response bekijken, zonder de bediening van de website ertussen. Postman voegt automatische controles op de statuscode en inhoud toe. Robot Framework test de hele route via de gebruikersinterface. Samen maken ze zichtbaar hoe je dezelfde service op verschillende manieren kunt onderzoeken.
Dit project wordt hier toegelicht. De interactieve demo, API en actuele testresultaten zijn niet actief in deze statische versie.
Wat laat het zien? Datagedreven API-tests met één code per request en gescheiden CSV-testdata.
In de volledige demo: Zoek de testtrofee met je eigen CSV, via Postman of de online runner.
Wat leer je ervan? Hoe één requestdefinitie en herbruikbare assertions veel testwaarden controleren.
Een kleine API, een gouden resultaat
Soms begint een software-experiment met iets heel eenvoudigs: stuur een code op en kijk wat er terugkomt. In dit losse project ga je met een API-tool op zoek naar een geheime prijscode. Met CSV-testdata laat je dezelfde requestdefinitie automatisch voor veel waarden draaien: één code per HTTP-aanroep, met assertions op het API-contract. De OpenAPI-specificatie is de handleiding voor de service: welke invoer verwacht hij, en welke antwoorden kun je krijgen? Probeer het via de website of ontdek het endpoint met je eigen API-tool.
De trofee is voor de lol. De techniek erachter is een voorbeeld uit het testvak: scheid je testdata van je script en laat dezelfde API-controle automatisch voor veel invoerwaarden draaien. Zo hoef je niet duizenden keren zelf een code in te typen.
De geheime code ligt tussen 20260000 en 20269999. Deze service accepteert één code per GET-request. In Postman definieer je dat request één keer met {{code}}. De Collection Runner haalt vervolgens elke code uit een CSV-regel en voert het request opnieuw uit. Eén requestdefinitie dus, maar maximaal 10.000 afzonderlijke HTTP-aanroepen.
De specificatie geeft ons het contract voor de assertions: geldige invoer levert HTTP 200, de response bevat dezelfde code en gewonnen is een boolean. Bij de prijs hoort gewonnen = true. Een verkeerde, maar geldige code geeft false; dat is verwacht gedrag en geen softwarefout. Het script controleert aan het einde of de zoekrun een winnaar heeft gevonden. Daarmee vind je de juiste testwaarde; zonder vooraf bekende verwachte uitkomsten test je hiermee nog niet of élke code functioneel correct is beoordeeld.
Oefen je afwegingen als tester in een retrospel of toets je kernkennis van Robot Framework.
Dit project wordt hier toegelicht. De interactieve demo, API en actuele testresultaten zijn niet actief in deze statische versie.
Wat laat het zien? Testdenken in drie korte missies: invoervalidatie, API-controle en regressie.
In de volledige demo: Loop naar de stations en kies de best onderbouwde testactie.
Wat leer je ervan? Waarom assertions, reproduceerbare bevindingen en gerichte regressie meer vertellen dan alleen een groen vinkje.
Testen als avontuur
Een eigen spel, met eigen graphics: geen emulator of gedownloade ROM. In Tester Quest onderzoek je risico’s, beoordeel je API-responses en kies je regressietests. Een speelse kennismaking met de afwegingen van een tester.
Dit project wordt hier toegelicht. De interactieve demo, API en actuele testresultaten zijn niet actief in deze statische versie.
Wat laat het zien? De essentiële frameworkkennis, vertaald naar zelfgeschreven meerkeuzevragen.
In de volledige demo: Tien introductievragen zonder beoordeling, gevolgd door veertig oefenvragen met vijf opties en één of twee juiste antwoorden.
Wat leer je ervan? Waarom een antwoord klopt, met uitleg en verwijzingen naar de syllabus. Vanaf 26 van 40 ontvang je een onofficieel oefenbewijs.
Kennis delen · Robot Framework
Ik werk al een paar jaar met Robot Framework en behaalde in 2026 mijn Robot Framework Certified Professional-certificaat. Met deze zelfgemaakte oefening deel ik mijn enthousiasme en spreek ik mijn dank en steun uit voor de mensen achter het framework en de syllabus.
Deze onafhankelijke oefening is gebaseerd op de Robot Framework Certified Professional-syllabus, versie 1.1.0 ↗. De vragen zijn zelf opgesteld; het zijn geen officiële examenvragen. Deze website is geen erkende examenaanbieder en staat los van Robot Framework Foundation en certificeringsaanbieders.
Dank aan de Robot Framework-community en Foundation voor het framework, de documentatie en de syllabus. Dit project is mijn manier om waardering en steun te tonen door kennis te delen; het is geen officiële samenwerking of financiële steunverklaring.
De beoordelingsgrens van deze oefening is 26 volledig juiste vragen van 40. Bij meer dan één juist antwoord moet de volledige selectie kloppen; er zijn geen deelpunten. Dit is een oefenregel, geen claim over alle regels van het officiële examen. Het oefenbewijs is geen erkend certificaat.
De vragen bestrijken de hoofdstukken over architectuur, syntaxis, uitvoering, keywordimports, argumenten, variabelen, hergebruik, setups, teardowns, tags en control structures. Het is een selectie van de leerdoelen, geen volledige vervanging van studie of praktijkervaring.
Naast functionele controles onderzoek ik hoe een functie reageert wanneer meerdere bezoekers haar tegelijk gebruiken. Deze eerste, begrensde proef richt zich op mijn berichtenfunctie.
Dit project wordt hier toegelicht. De interactieve demo, API en actuele testresultaten zijn niet actief in deze statische versie.
Wat laat het zien? Een loadtest met drie gelijktijdige bezoekers, met aandacht voor responstijden, HTTP-uitkomsten en correcte opslag.
In de volledige demo: Bekijk en download het JMeter-testplan. Ik voer de metingen zelf uit, eerst lokaal en daarna in een kleine proef op mijn NAS.
Wat leer je ervan? Hoe je belasting en verwachtingen vooraf vastlegt en een verwachte afwijzing onderscheidt van een technische fout.
Volg de zes stappen van mijn bestaande testplan. De animatie duurt ongeveer achttien seconden en gebruikt fictieve voorbeeldgegevens. Zij start geen JMeter-run, verstuurt geen aanvragen en verandert geen limiet.
1 · Opzet
Het JMeter-testplan gebruikt drie threads: drie virtuele bezoekers. Iedere bezoeker verstuurt vijf berichten. Een pauze van één seconde en een synchronisatietimer sturen het ritme. Dit is een kleine loadtest met vooraf gekozen belasting, geen zoektocht naar maximale capaciteit.
Testperspectief: Wat leg je vooraf vast? Aantal bezoekers, inzendingen, pauzes, omgeving en verwachte uitkomsten. Voor de nulmeting is geen willekeurige responstijdnorm bedacht.
Beide proeven gebruiken drie bezoekerssessies, ieder met vijf inzendingen en één seconde pauze per inzending. De ontvangstlimiet stond op 100, zodat deze vijftien aanvragen niet door de ingestelde limiet werden afgewezen. De cijfers hieronder horen uitsluitend bij de JMeter-meting Bericht versturen.
| Meting | Lokaal · HTTP | NAS · HTTPS |
|---|---|---|
| Start proef · Nederlandse tijd | 10 oktober · 00:39:44 | 10 oktober · 08:08:49 |
| Berichtinzendingen | 15 | 15 |
| Onverwachte fouten | 0 · 0% | 0 · 0% |
| Gemiddelde responstijd | 64 ms | 66,93 ms |
| Mediaan | 66 ms | 64 ms |
| 95e percentiel | 118 ms | 121 ms |
| Minimum / maximum | 25 / 118 ms | 26 / 121 ms |
| Throughput in deze proef | 3,29 inzendingen/s | 3,36 inzendingen/s |
| Passende opgeslagen berichten | 15 van 15 | 15 van 15 |
De lokale limiettest startte op 10 oktober om 00:44:47 met een limiet van tien en een schone lokale uurtelling. Drie bezoekers deden opnieuw vijftien inzendingen: tien kregen HTTP 201 en vijf HTTP 429. De opslagcontrole vond precies tien passende berichten en geen opgeslagen berichten voor de vijf afwijzingen. De test en opslagcontrole zijn geslaagd. De limiettest op de NAS is nog niet uitgevoerd.
Bron van deze resultaten: de uitgevoerde JMeter-proeven, de bijbehorende HTML-statistieken en het aparte opslagcontroleprogramma. Het zijn mijn eigen, verkennende metingen; geen onafhankelijke certificering of garantie voor iedere belasting.
In beide nulmetingen waren alle vijftien inzendingen succesvol en correct opgeslagen. Het gemiddelde op de NAS lag 2,93 ms hoger dan lokaal; het 95e percentiel lag 3 ms hoger. De lokale mediaan was juist iets hoger. Met één korte proef per omgeving zijn deze kleine verschillen onvoldoende om een betekenisvol verschil in performance vast te stellen.
Een complete uitvoering bevat twintig metingen: één initialisatie, drie formulieraanvragen, vijftien berichtinzendingen en één eindcontrole. Het gemiddelde over alle twintig metingen was 108,45 ms lokaal en 230,75 ms op de NAS. Die totalen mengen HTTP-aanvragen met lokale JMeter-scriptstappen en zijn daarom geen zuivere responstijd van de berichtenservice.
Het ophalen van het formulier en de sessie duurde gemiddeld 93 ms lokaal en 918,67 ms op de NAS. Dat verschil is zichtbaar, maar deze meting verklaart de oorzaak niet. Netwerk, HTTPS, paginaoverdracht en verwerking op de server zijn mogelijke onderzoekspunten; zonder aanvullende metingen wijs ik geen oorzaak aan.
De mediaan geeft het midden van de gemeten responstijden weer. Het 95e percentiel beschrijft de hoge kant van de verdeling; JMeter berekent dit uit de meetreeks. Bij slechts vijftien inzendingen ligt die waarde hier dicht bij het maximum. Meer herhaalde metingen zijn nodig voor een stabiel beeld van trage aanvragen.
De throughput is het aantal gemeten inzendingen per seconde binnen deze proef. Die waarde wordt ook beïnvloed door het aantal bezoekers, de pauzes en het korte meetvenster. Ongeveer drie inzendingen per seconde betekent dus niet dat de server maximaal drie aanvragen per seconde aankan.
Voor deze nulmeting is vooraf geen maximale responstijd afgesproken. Succes betekent hier: de functionele verwachtingen en opslagcontroles zijn gehaald, terwijl de responstijden als uitgangspunt zijn vastgelegd. De APDEX-grenzen in het JMeter-rapport zijn rapportinstellingen en vormen geen door mij gekozen acceptatiecriteria.
De NAS-proef gebruikt de online HTTPS-route; de lokale proef gebruikt de PHP-ontwikkelserver en lokale opslag. Die ontwikkelserver kan verzoeken achter elkaar verwerken. Drie gelijktijdige JMeter-bezoekers betekenen bovendien niet dat de server precies drie verzoeken tegelijk verwerkt. De omgevingen en omstandigheden verschillen; deze proeven zijn een eerste vergelijking, geen stresstest, duurtest of capaciteitsbepaling.
Ik leg het doel, de belasting en de verwachte uitkomsten vast. Voor de nulmeting maak ik voldoende ruimte in de uurlimiet; voor de limiettest moet de uurtelling aan het begin leeg zijn. Tijdens die limiettest mogen andere inzendingen de telling niet beïnvloeden. Een nieuwe resultatenmap voorkomt dat uitvoeringen worden samengevoegd.
JMeter haalt per bezoeker het formulier op, bewaart een eigen sessiecookie en leest het CSRF-token. Dit bootst de HTTP-sessie van een bezoeker na. JMeter voert hierbij geen JavaScript uit en meet niet hoe snel de pagina in een browser wordt getekend.
Iedere bezoeker verstuurt vijf berichten met een unieke bericht-ID. Een runcode maakt de testberichten herkenbaar. Een pauze van één seconde begrenst de belasting; een synchronisatietimer laat de drie bezoekers per ronde samen starten. De aanvragen bevatten JSON, het CSRF-token en een Origin-header passend bij de testomgeving.
Het PHP-endpoint controleert onder meer de sessie, het token en de invoer. Daarna gebruikt het een bestandsvergrendeling om de gedeelde uurtelling en opslag te beschermen tegen gelijktijdige wijzigingen. Binnen die vergrendeling leest het de ingestelde limiet, controleert de afgelopen zestig minuten en reserveert een plek voordat het bericht wordt opgeslagen. Een geldig nieuw bericht krijgt een eigen JSON-bestand in de privémap op mijn NAS; een bereikte limiet leidt tot HTTP 429.
Een geaccepteerd bericht moet HTTP 201 en een geldige JSON-response met ok: true teruggeven. Bij de nulmeting zijn vijftien successen vereist. Bij de limiettest zijn tien successen en vijf HTTP 429-afwijzingen vereist. In die tweede test telt een verwachte 429 als geslaagde controle; de oorspronkelijke statuscode blijft zichtbaar in het JTL-resultaat. De eindcontrole toetst de aantallen, niet alleen het algemene foutpercentage.
Het Python-controleprogramma leest de JTL-metingen en vergelijkt de bericht-ID’s met de opgeslagen JSON-bestanden. Het controleert of ieder geaccepteerd bericht een passend bestand heeft, of afgewezen berichten niet zijn opgeslagen en of het aantal bestanden van deze run klopt. Deze controle leest uitsluitend; zij wijzigt of verwijdert geen berichten. Beide nulmetingen en de lokale limiettest gaven ok: true.
Na de proef herstel ik de normale ontvangstlimiet. Pas na de opslagcontrole verwijder ik herkenbare testberichten via mijn laptopclient. De rapporten blijven beschikbaar voor analyse. Ik start deze performanceproeven handmatig vanaf mijn laptop; bezoekers kunnen hier geen belastingtest starten. Ze staan los van de geplande testbewaking en tellen niet mee op het testbriefje.
De volgende stap is de NAS-limiettest. Daarna kunnen herhaalde metingen helpen om een realistische prestatienorm en een volgende onderzoeksvraag te kiezen.
Performancetesten onderzoeken hoe snel, stabiel en betrouwbaar software reageert onder een beschreven belasting. Een loadtest is een vorm daarvan: we bieden een afgesproken hoeveelheid gelijktijdig gebruik aan en meten het gedrag. Correctheid onder belasting onderzoekt daarnaast of uitkomsten en opslag consistent blijven. Een stress- of duurtest is een andere onderzoeksvraag en valt buiten deze eerste opzet.
Om prestatie-eisen te toetsen, knelpunten te ontdekken, capaciteit te plannen en vertragingen na wijzigingen op te sporen. De resultaten helpen bij een onderbouwd releasebesluit. Daarvoor moeten de belasting, omgeving en meetduur passen bij het werkelijke gebruik. Deze kleine portfolio-opzet laat die werkwijze zien zonder te claimen dat daarmee een volledige productiebelasting is getest.
Bron voor de gebruikte JMeter-componenten: Apache JMeter · officiële componentdocumentatie ↗.
Voor scripts en API-tools is er een aparte REST-API voor de globale berichtenlimiet. Met GET lees ik de actuele limiet; met PATCH wijzig ik max_per_hour. Beide aanvragen vereisen een privé bearer-token. Het portaal en deze API gebruiken dezelfde instelling en bestandsvergrendeling.
Voor een performanceproef kan een script de limiet eerst lezen en later herstellen. Het geheime token wordt niet op de website getoond en is geen onderdeel van de download. De OpenAPI-specificatie ↓ (volledige versie) beschrijft de verzoeken en statuscodes.
Het plan start standaard lokaal op http://127.0.0.1:8000. Het bevat drie bezoekers, vijf inzendingen per bezoeker, sessiebeheer, CSRF-verwerking, pauzes en een controle van de totaalaantallen. Met mode=baseline of mode=limit kies ik de verwachting; host, protocol en poort bepalen de testomgeving.
jmeter -n -t berichten_performance.jmx -l meting.jtl -e -o html-rapport -Jmode=baseline -Jsample_variables=test_run,message_id -Jhttpclient4.retrycount=0Voor de limiettest gebruik ik mode=limit en stel ik vooraf de limiet op tien in. De afgelopen zestig minuten mogen dan geen inzendingen meetellen. Het plan wijzigt of wist de uurtelling niet.
Uit het vak · om over na te denken
Ideeën uit lezingen, gesprekken en mijn eigen testpraktijk. Hier schrijf ik op wat me aan het denken zet en hoe dat aansluit bij mijn werk en dit portfolio.
· Softwarekwaliteit · PHP · Beveiliging en beheer
Het nieuws over kritieke PHP-lekken volg ik met interesse. Mijn eigen testportfolio gebruikt PHP. Wat betekent dat voor mijn beheer, en hoe verhoudt het dalende gebruiksaandeel zich tot andere technologieën?
Lees het artikelHet NOS-bericht over ernstige beveiligingslekken in PHP ↗ trok direct mijn aandacht. Ik volg ontwikkelingen in softwarekwaliteit met interesse, maar dit onderwerp staat ook dicht bij mijn eigen praktijk: dit testportfolio draait deels op PHP en wordt op mijn eigen NAS gehost.
Ik leer op deze site niet alleen hoe ik functies bouw en test, maar ook wat het betekent om software te beheren. Een website kan prima reageren op de knoppen en formulieren, terwijl er onderliggend onderhoud nodig is. Dat onderscheid vind ik belangrijk.
Het PHP-beveiligingsteam kondigde op 20 oktober een beveiligingsrelease aan voor twee kritieke kwetsbaarheden, beide met een CVSS v4.0-score van 9,2. De aangekondigde publicatietijd was 21 oktober om 14:00 UTC, oftewel 16:00 Nederlandse tijd. In die vooraankondiging werden de technische details, getroffen versies en gerepareerde versies nog niet volledig gegeven.
Een aangekondigde reparatie is iets anders dan een geïnstalleerde reparatie. Voor een beheerder blijft de vraag welke software daadwerkelijk draait en welke update voor die omgeving beschikbaar is. Daarom zijn de officiële PHP-informatie en de berichten van de leverancier van het hostingplatform belangrijker dan een losse conclusie op basis van een krantenkop.
Stand van dit artikel: 21 oktober 2026, gebaseerd op de geraadpleegde vooraankondiging en het CERT-EU-advies. Dit artikel is geen live overzicht van patchstatussen. Raadpleeg voor latere informatie de actuele bronnen onderaan.
W3Techs laat tussen 1 oktober 2025 en 21 oktober 2026 een daling voor PHP zien, van 73,4% naar 69,3%. JavaScript stijgt in dezelfde meetreeks van 5,0% naar 8,1% en Ruby van 6,4% naar 7,1%.
| Servertechnologie | 1 oktober 2025 | 21 oktober 2026 |
|---|---|---|
| PHP | 73,4% | 69,3% |
| JavaScript | 5,0% | 8,1% |
| Ruby | 6,4% | 7,1% |
Dit betreft websites waarvan W3Techs de servertaal kan herkennen. Het is geen meting van alle software, ontwikkelaars of vacatures; een website kan meerdere talen gebruiken. Een kleiner relatief aandeel bewijst ook niet dat het absolute aantal PHP-websites daalt. De cijfers leggen geen oorzakelijk verband met deze beveiligingsmelding.
JavaScript draait niet alleen in de browser. Met bijvoorbeeld Node.js kan het ook servercode uitvoeren en HTTP-aanvragen afhandelen. Het groeiende aandeel in de W3Techs-reeks gaat hier over servergebruik, niet over de JavaScript-knoppen en animaties die bezoekers op webpagina’s zien.
Ruby groeit eveneens in deze meetreeks. Ruby on Rails is een bekend framework om met Ruby webapplicaties te bouwen. De taal en het framework zijn niet hetzelfde: de cijfers hierboven meten Ruby en bewijzen niet welk deel daarvan Rails gebruikt.
Python is een andere interessante richting, met bijvoorbeeld FastAPI voor het bouwen van API’s. De Stack Overflow Developer Survey van 2025 meldde een groei van zeven procentpunten in Python-gebruik ten opzichte van 2024, onder de deelnemers aan dat onderzoek. Dat gaat breder dan websites, onder meer over AI, data en backendontwikkeling.
Die populariteitsgroei is dus niet rechtstreeks te vergelijken met PHP’s aandeel bij W3Techs. Python groeit in dat ontwikkelaarsonderzoek, maar in de aangehaalde W3Techs-periode stijgt zijn gemeten websiteaandeel niet. Dat onderscheid voorkomt een te eenvoudig verhaal waarin één taal PHP overal zou vervangen.
PHP verzorgt op mijn site onder meer servercontroles, portaalfuncties en het verwerken van aanvragen. Dat betekent dat ik ook de PHP-runtime en het platform waarop die draait moet onderhouden. Alleen de broncode van mijn website bijwerken is daarvoor niet voldoende.
Mijn site gebruikt onder meer aanmeldcontrole en CSRF-tokens. Dat zijn nuttige maatregelen voor de applicatie, maar ze repareren geen kwetsbaarheid in PHP zelf. Ook het feit dat mijn website geen database heeft, neemt het risico van een kwetsbare serverruntime niet weg.
Of mijn concrete omgeving door dit specifieke probleem wordt geraakt, kan ik niet afleiden uit de titel van het nieuwsbericht of uit een geslaagde browsertest. Daarvoor moet ik de actieve PHP-versie, het gebruikte pakket en de relevante leveranciersinformatie naast elkaar leggen. In dit artikel geef ik daarom geen ongecontroleerde verklaring dat mijn omgeving veilig of juist aantoonbaar kwetsbaar is.
CERT-EU adviseert PHP-omgevingen in kaart te brengen en getroffen systemen snel te patchen. Als herstel niet direct mogelijk is, noemt het advies het tijdelijk isoleren van publiek bereikbare applicaties als te overwegen maatregel. De precieze actie hangt af van de actuele technische informatie en de eigen omgeving.
Een dalend gebruiksaandeel of een beveiligingsmelding maakt een taal voor mij niet automatisch ongeschikt. Het zet wel aan tot kritisch kijken: is de omgeving ondersteund, kan ik tijdig bijwerken en kan ik onderbouwen wat ik heb gecontroleerd? Een overstap naar een andere taal brengt bovendien eigen afhankelijkheden en onderhoud met zich mee.
Dat sluit aan bij wat ik met dit portfolio wil laten zien. Softwarekwaliteit gaat verder dan geslaagde testgevallen. Ook versiebeheer, onderhoud, betrouwbare bronnen en het herkennen van de grenzen van je eigen controles horen erbij. Dit nieuws is voor mij een concrete aanleiding om die verantwoordelijkheid serieus te nemen.
· TechEx Europe · Dag 2 · RAI Amsterdam
Van integratieplatformen en AI-agents tot sensoren, robots en datacenters. Mijn bezoek aan de tweede beursdag bracht vertrouwde technologie en nieuwe ideeën samen. Spectrum sprong er voor mij uit.
Lees het artikelOp dinsdag 20 oktober bezocht ik TechEx Europe in de RAI Amsterdam. Het evenement duurde twee dagen, maar ik heb de eerste dag overgeslagen en ben alleen op dag 2 geweest. Dit verslag gaat dus over mijn bezoek op die dinsdag.
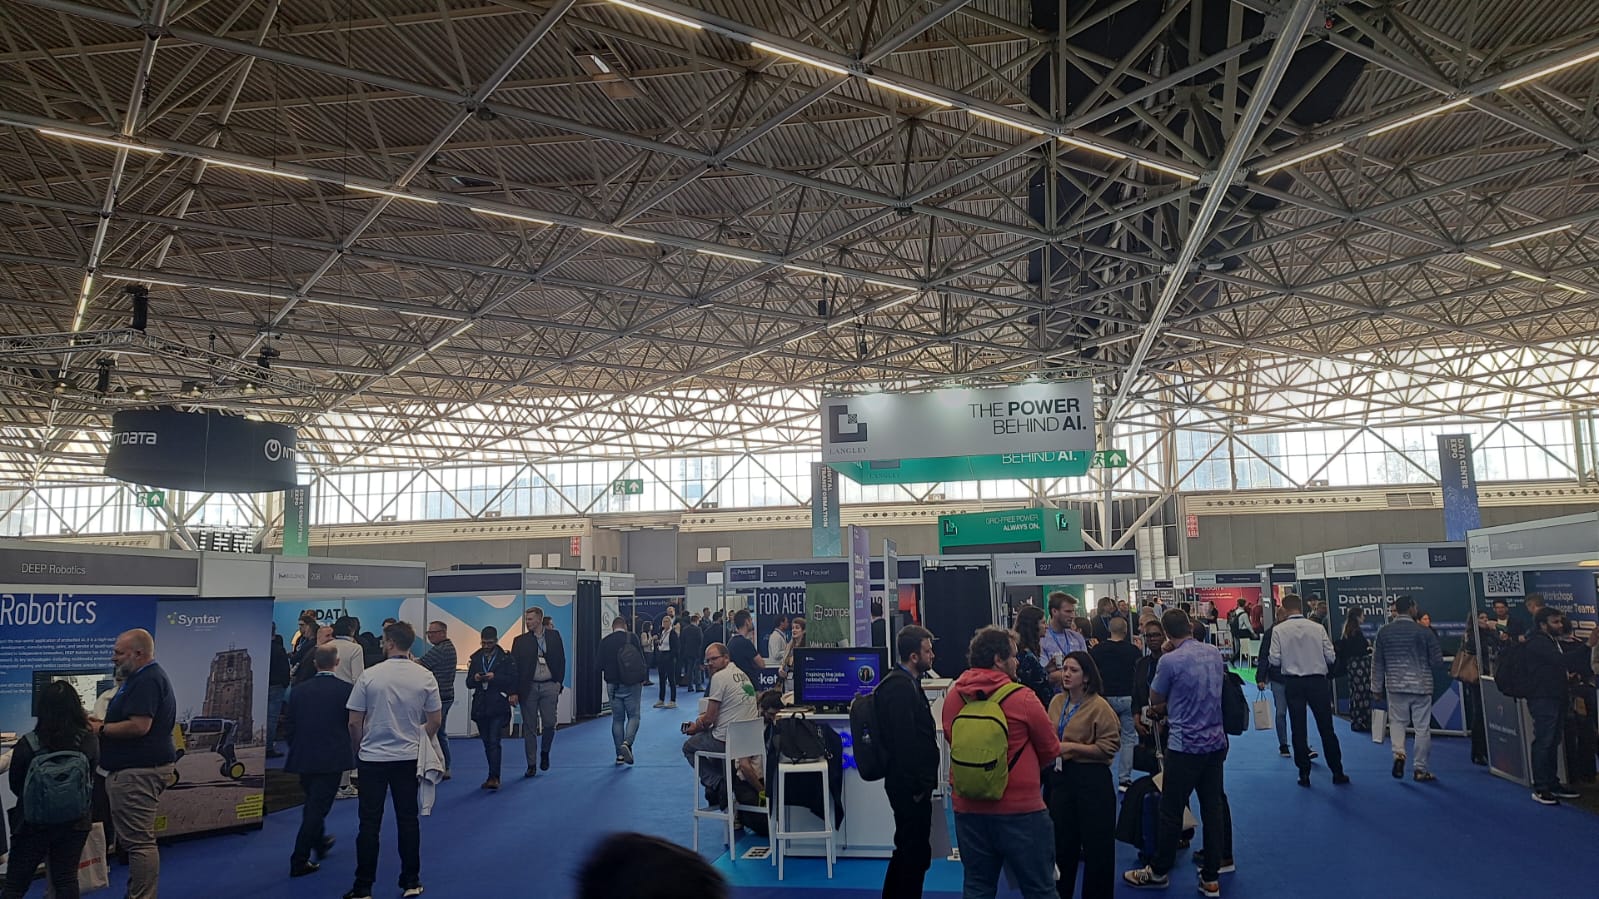
Als Senior Test Engineer met een focus op testautomatisering kijk ik graag verder dan mijn eigen specialisme. Softwareontwikkeling, architectuur, AI, integratie, infrastructuur en hardware maken allemaal deel uit van dezelfde IT-wereld. TechEx was voor mij een mooie gelegenheid om die samenhang te verkennen, demonstraties te bekijken en met mensen bij de stands in gesprek te gaan.
TechEx brengt verschillende technologiegebieden samen, van AI en cybersecurity tot IoT, automatisering en data-infrastructuur. Juist die combinatie sprak me aan. Tijdens mijn rondgang zag ik hoe AI steeds vaker onderdeel is van bestaande producten en processen: niet alleen bij softwareontwikkeling, maar ook bij gegevensverwerking, infrastructuur en fysieke robots.
Mijn belangrijkste indruk: nieuwe mogelijkheden krijgen pas waarde als de basis klopt. Je hebt betrouwbare gegevens, voldoende context, goede integraties en een veilige infrastructuur nodig. Dat zijn onderwerpen die ook vanuit softwarekwaliteit interessant blijven.
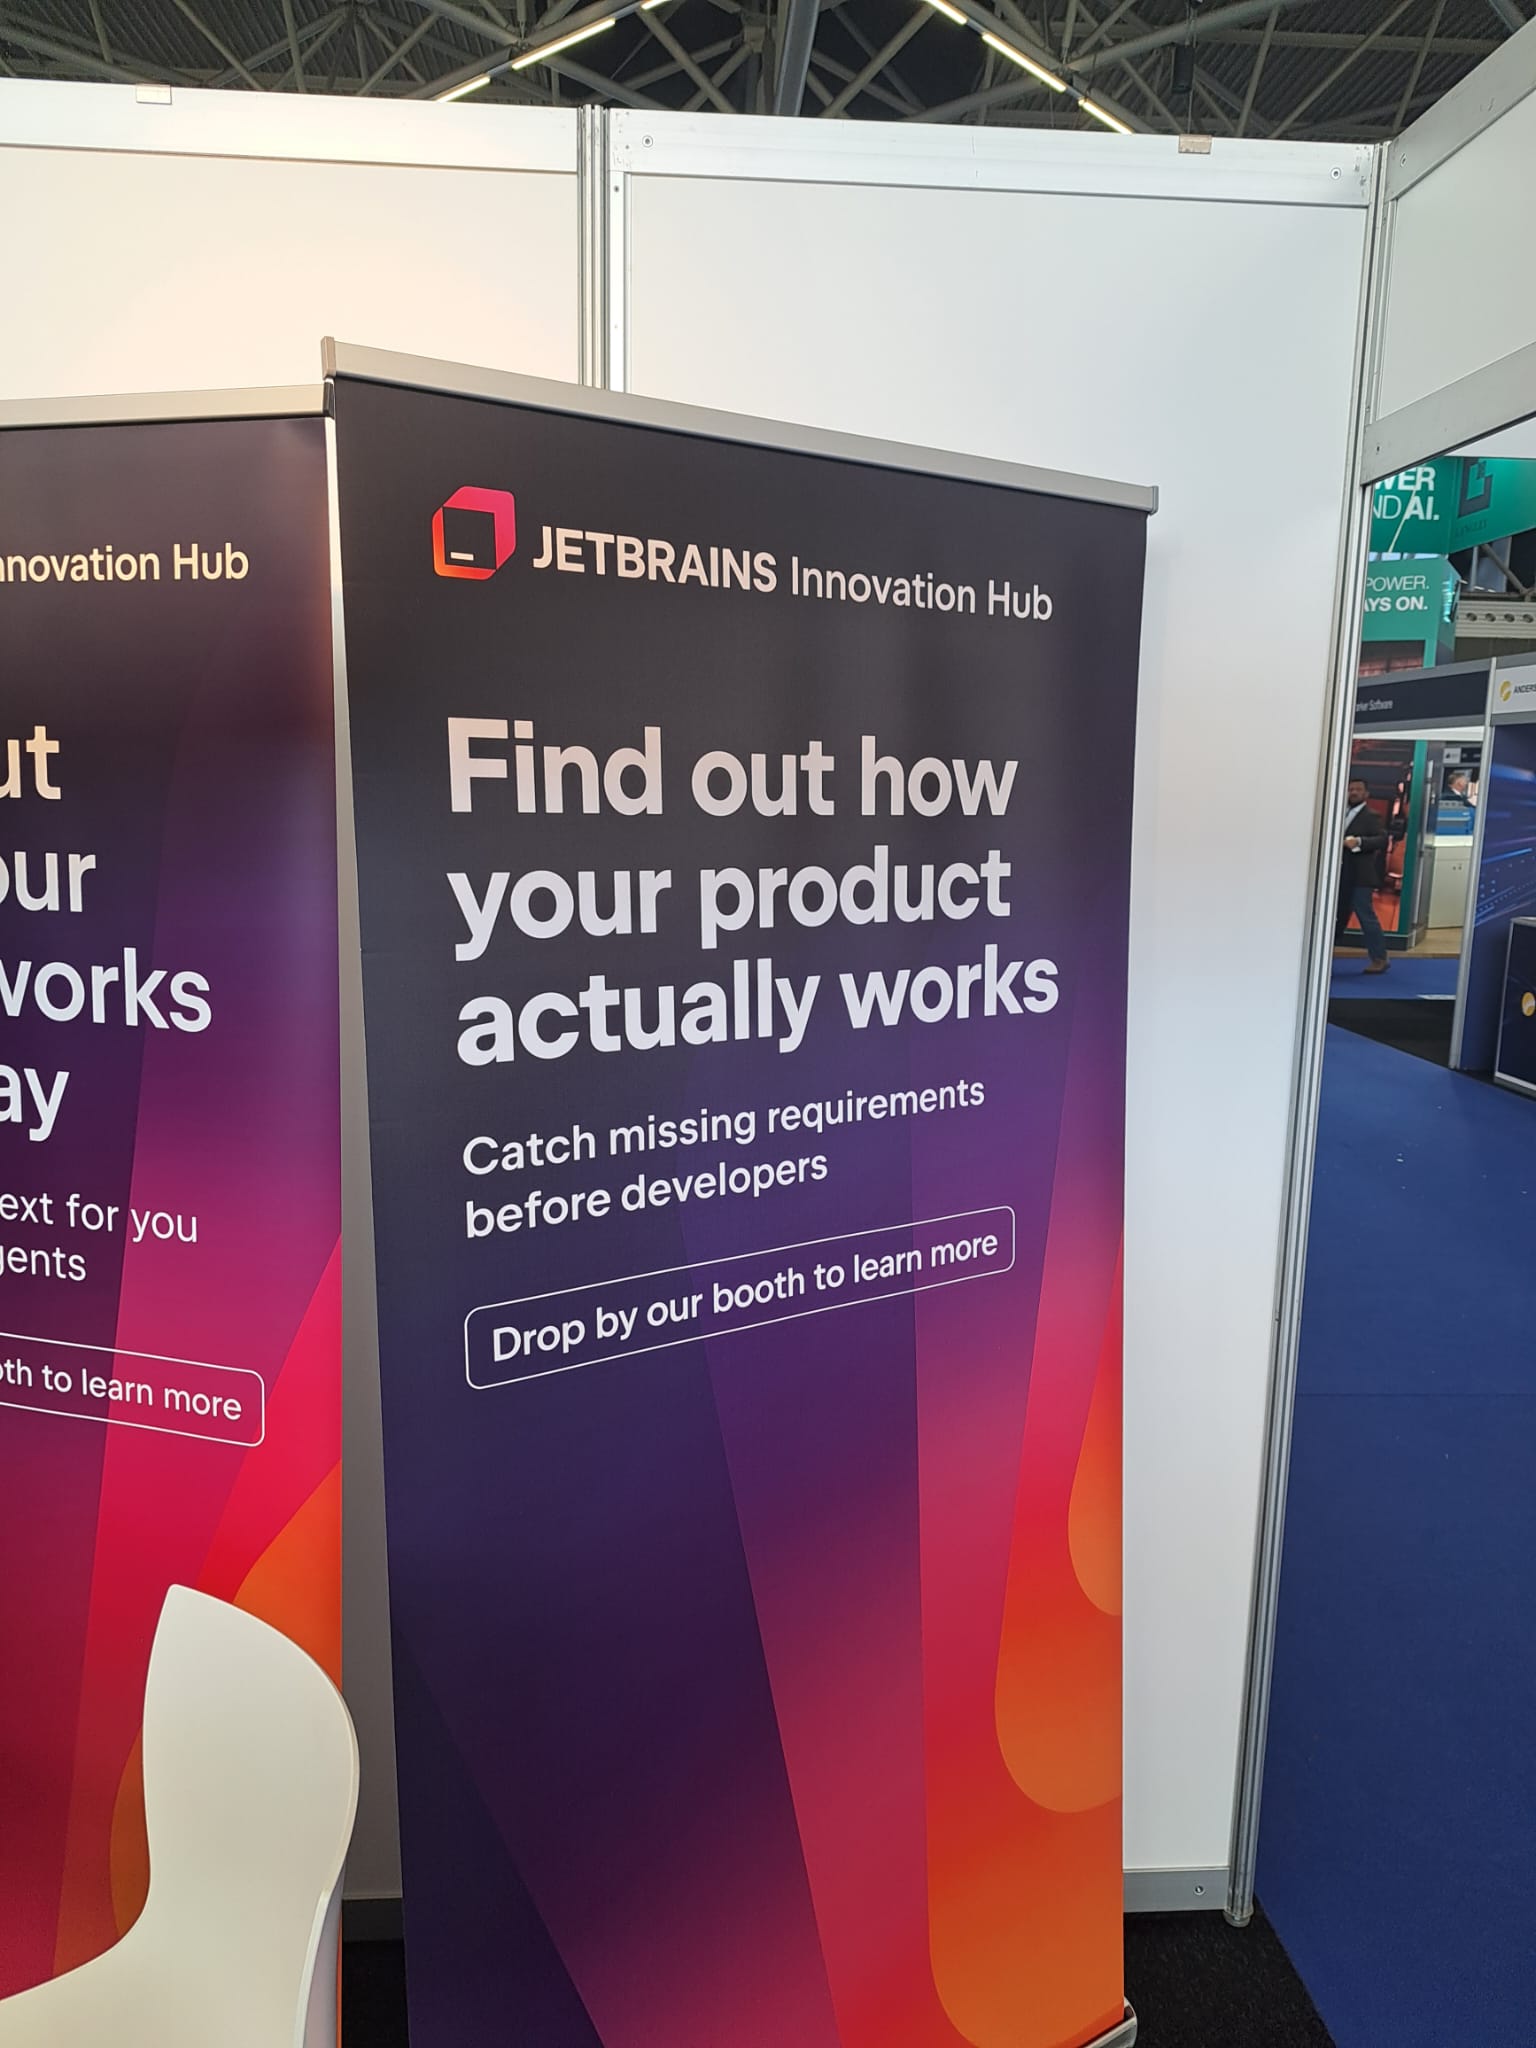
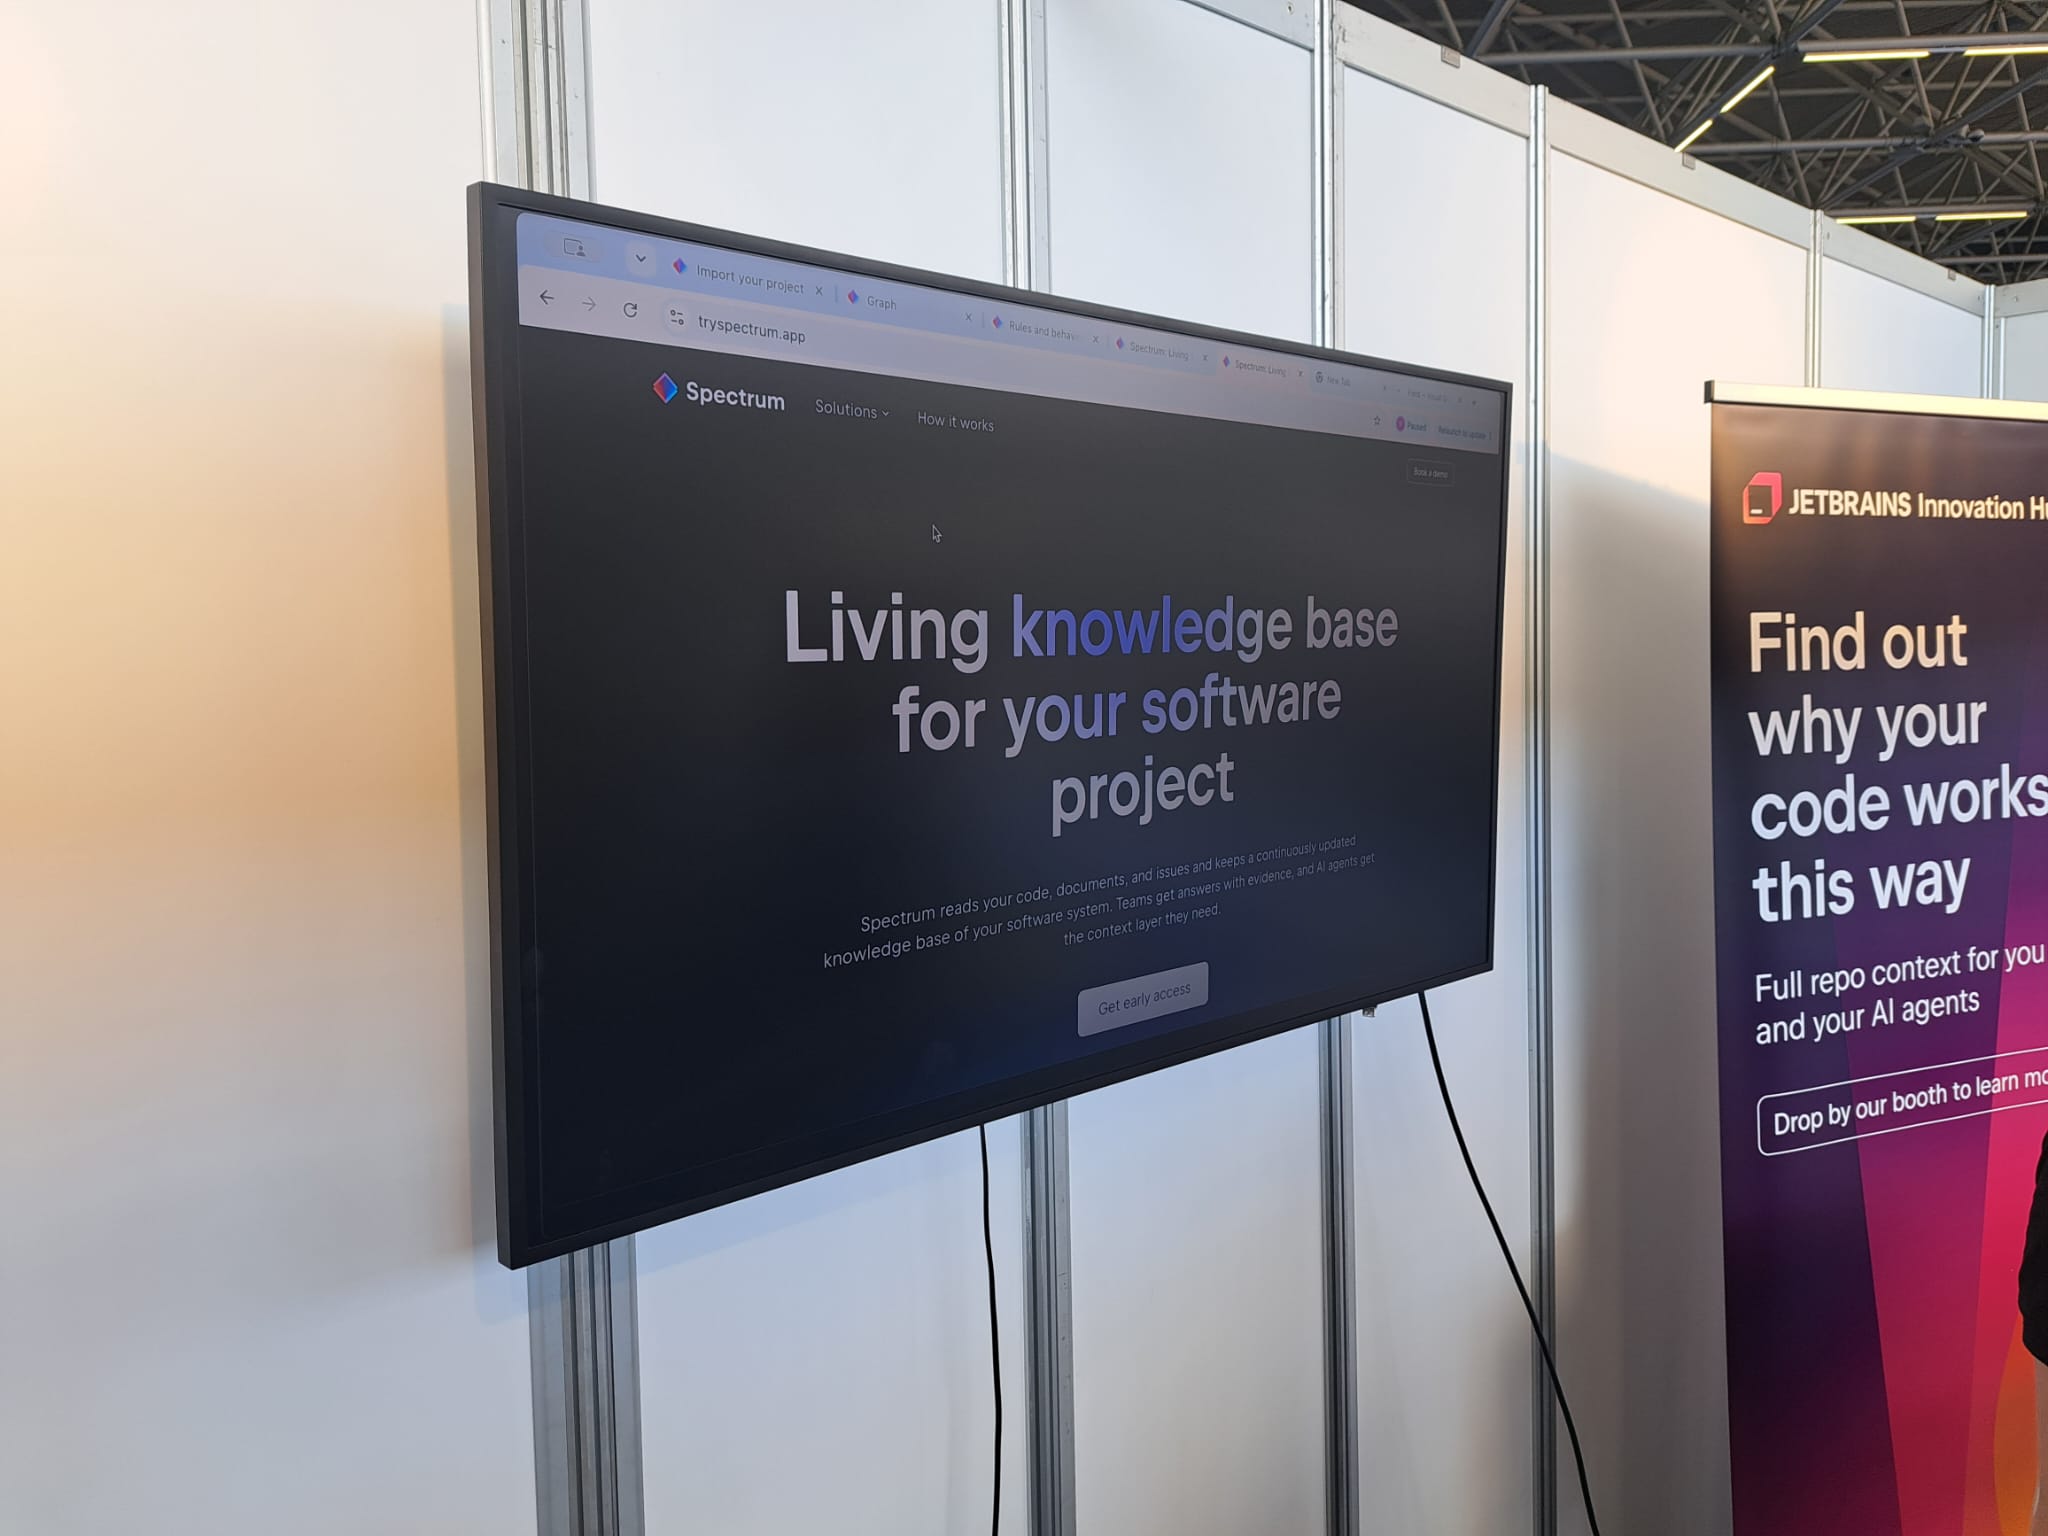
De kennismaking met Spectrum, dat ik bij de JetBrains Innovation Hub tegenkwam, bleef me het meest bij. Het idee is een levende kennisbank voor een softwareproject: informatie uit code, documenten en issues wordt met elkaar verbonden en bijgehouden. Daarmee wil Spectrum teams én AI-agents helpen om een systeem beter te begrijpen.
Dat herken ik als een relevant vraagstuk. Requirements, technische keuzes, architectuur en de daadwerkelijke implementatie staan vaak op verschillende plekken. Daardoor kost het tijd om te achterhalen hoe iets werkt, waarom het zo gebouwd is en wat een wijziging kan raken.
Ik zie mogelijke toepassingen bij impactanalyses en het uitwerken van testscenario’s. Als de verbanden tussen requirements, ontwerp en implementatie beter zichtbaar worden, kan dat helpen om gerichter vragen te stellen en controles te kiezen. Dat is voor mij een interessante mogelijkheid, nog geen bewezen uitkomst.
Bij de stand heb ik hierover gesproken. We hebben afgesproken dat ik informatie of demogegevens ontvang, zodat ik Spectrum zelf kan uitproberen. Daar ben ik benieuwd naar: hoe actueel en betrouwbaar is het kennismodel, hoe zijn antwoorden onderbouwd en wat voegt het toe bij een bestaand softwareproject? Mijn enthousiasme gaat over het concept; de praktische beoordeling moet nog volgen.
Na mijn bezoek werd steeds duidelijker waarom Spectrum me zo aanspreekt. Ook op mijn eigen website wil ik de samenhang tussen software, tests, beheer en documentatie beter zichtbaar houden. De site is mijn testportfolio én mijn leeromgeving. Naarmate die groeit, wil ik kunnen nagaan of de uitleg nog overeenkomt met de software die daadwerkelijk draait.
Die kennismaking heeft me geïnspireerd om geautomatiseerd documentatiebeheer te gaan verkennen. Mijn idee: een dagelijkse taak op mijn NAS die met scripts controleert welke documenten mogelijk verouderd zijn. Denk aan een gewijzigde bestandsnaam, een aangepaste instelling of een beschrijving van een functie die inmiddels anders werkt.
Ik wil klein beginnen: vastleggen welke documenten bij welke onderdelen horen en vervolgens verschillen zichtbaar maken. Feiten die betrouwbaar uit code of configuratie zijn af te leiden, wil ik uiteindelijk automatisch laten bijwerken, zonder iedere keer zelf bestanden te hoeven aanpassen.
Voor inhoudelijke uitleg wil ik eerst een controleverslag of wijzigingsvoorstel krijgen. Waarom iets is ontworpen zoals het is en wat een testresultaat bewijst, vraagt om een eigen afweging. Zo kan automatisering mij werk uit handen nemen, terwijl ik verantwoordelijk blijf voor de betekenis van de documentatie.
De uitwerking moet nog beginnen. Een eerste proef zou geslaagd zijn als een bewust gewijzigde bestandsnaam wordt gesignaleerd, de melding naar de juiste bron verwijst en bestaande uitleg behouden blijft. Dat lijkt me een mooi nieuw onderwerp voor dit portfolio: documentatie niet alleen schrijven, maar ook aantoonbaar onderhouden.
Bij Boomi ben ik bewust langsgegaan, omdat ik in het verleden met het platform heb gewerkt. Boomi biedt een integratieplatform waarmee applicaties, systemen en databronnen gekoppeld kunnen worden: een Integration Platform as a Service, of iPaaS.
Het was interessant om opnieuw kennis te maken met het platform en te zien hoe onderwerpen als API-management, gegevensbeheer en AI terugkomen in het aanbod. In een landschap met veel verschillende systemen blijft de vraag hoe die systemen betrouwbaar samenwerken. Juist die verbinding tussen onderdelen vind ik boeiend.
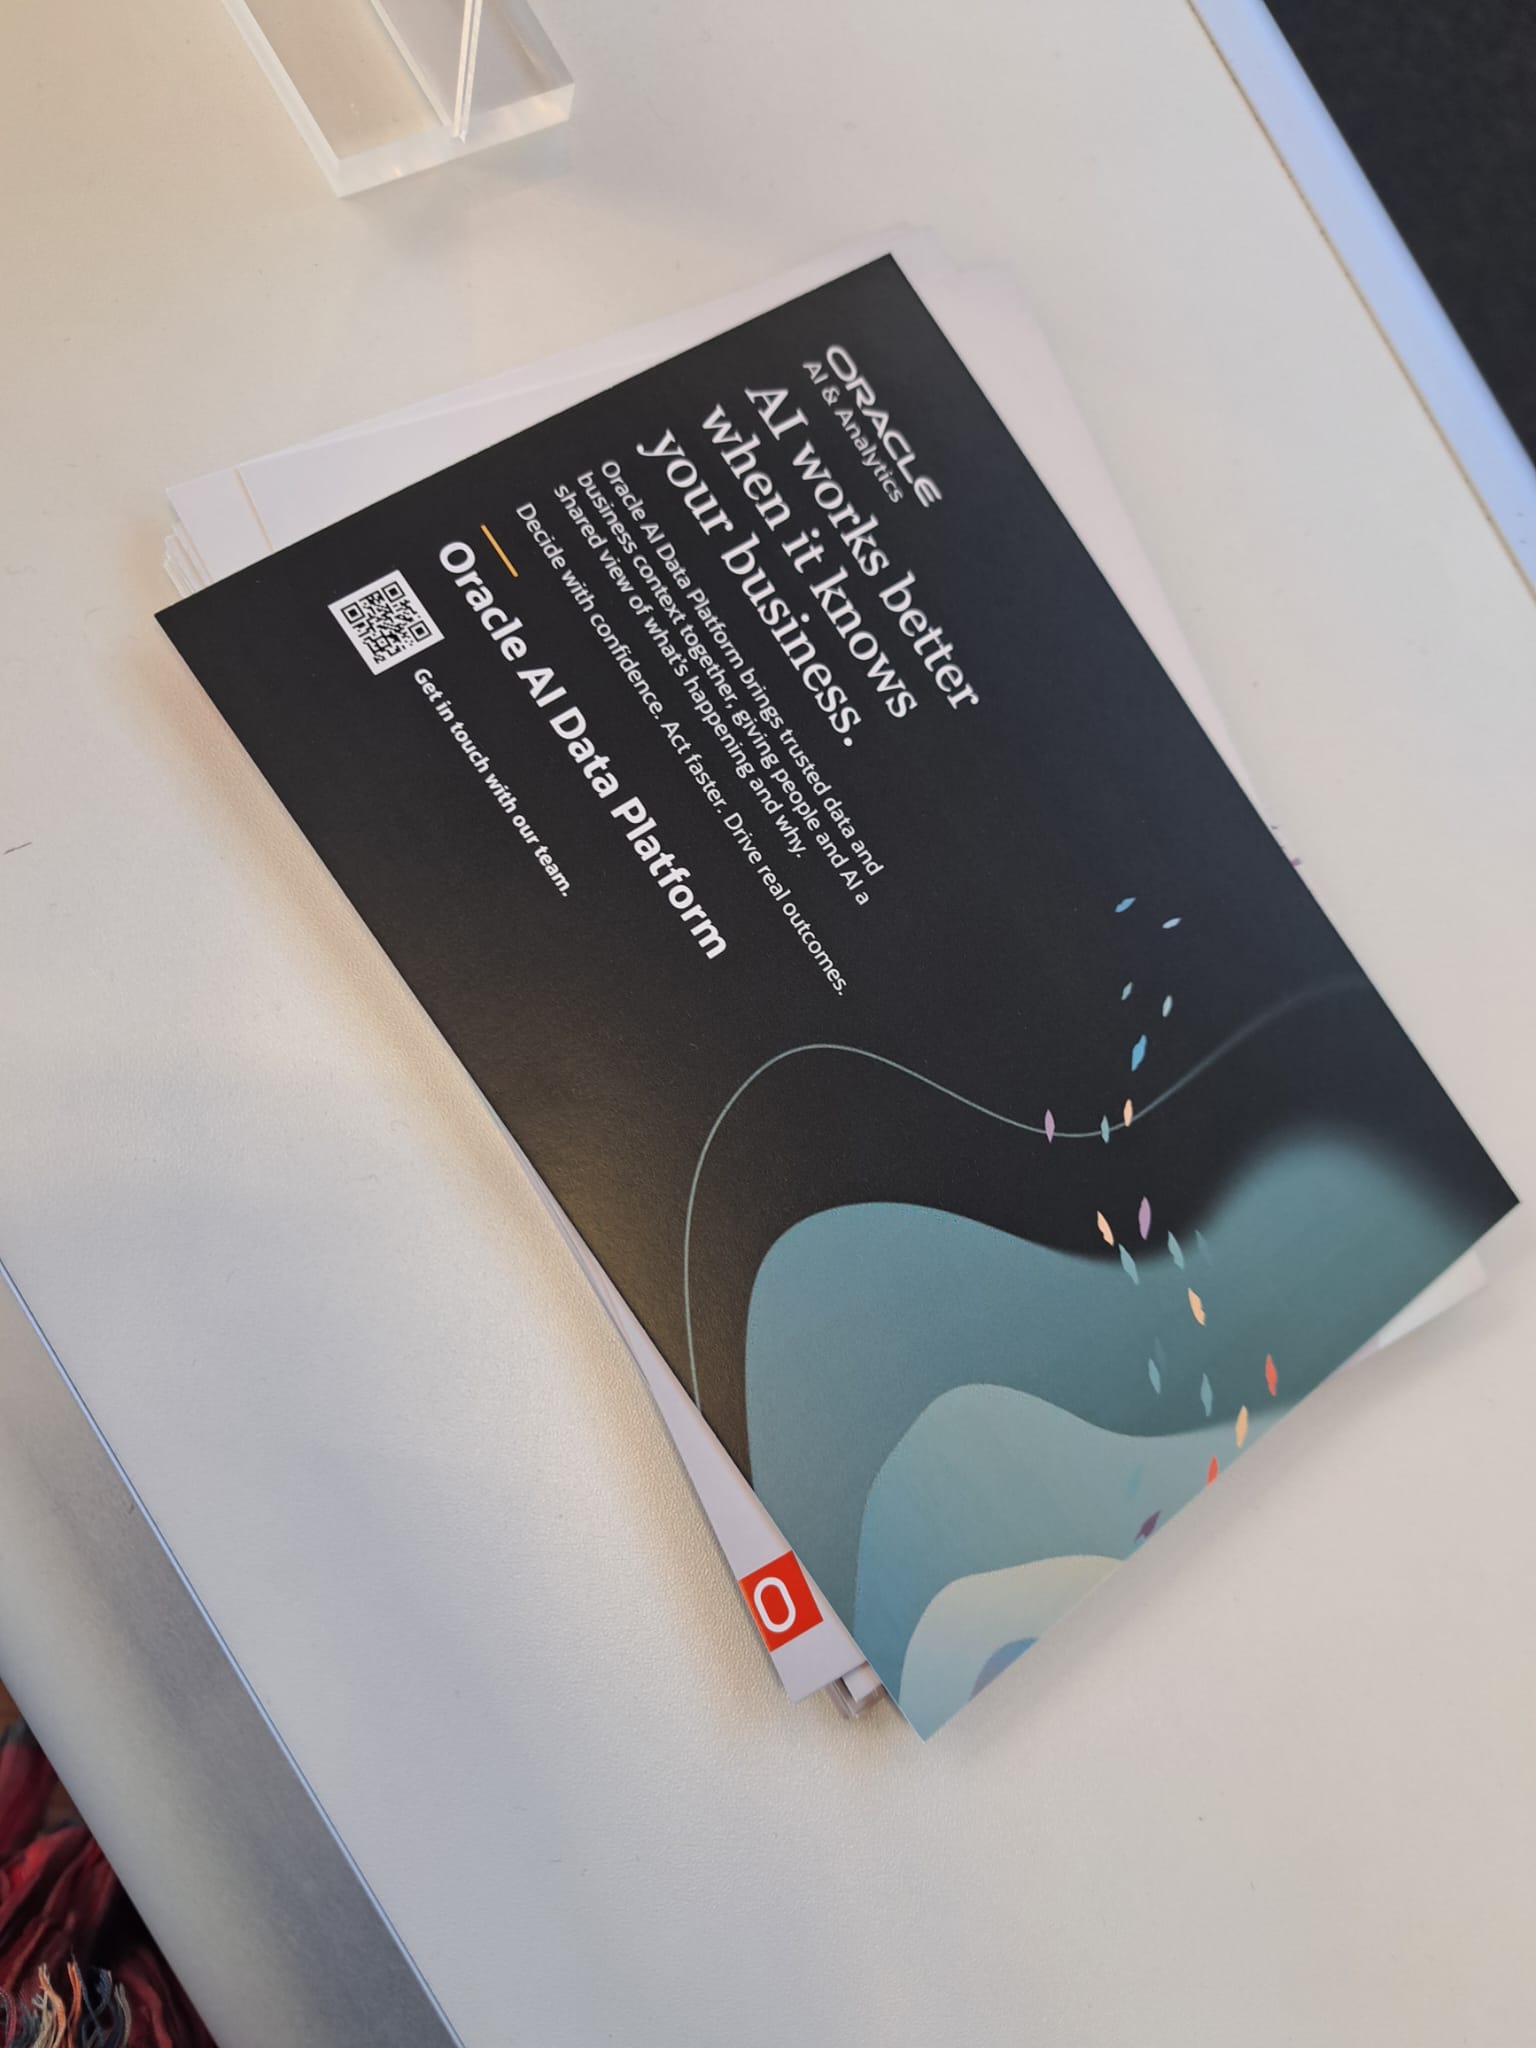
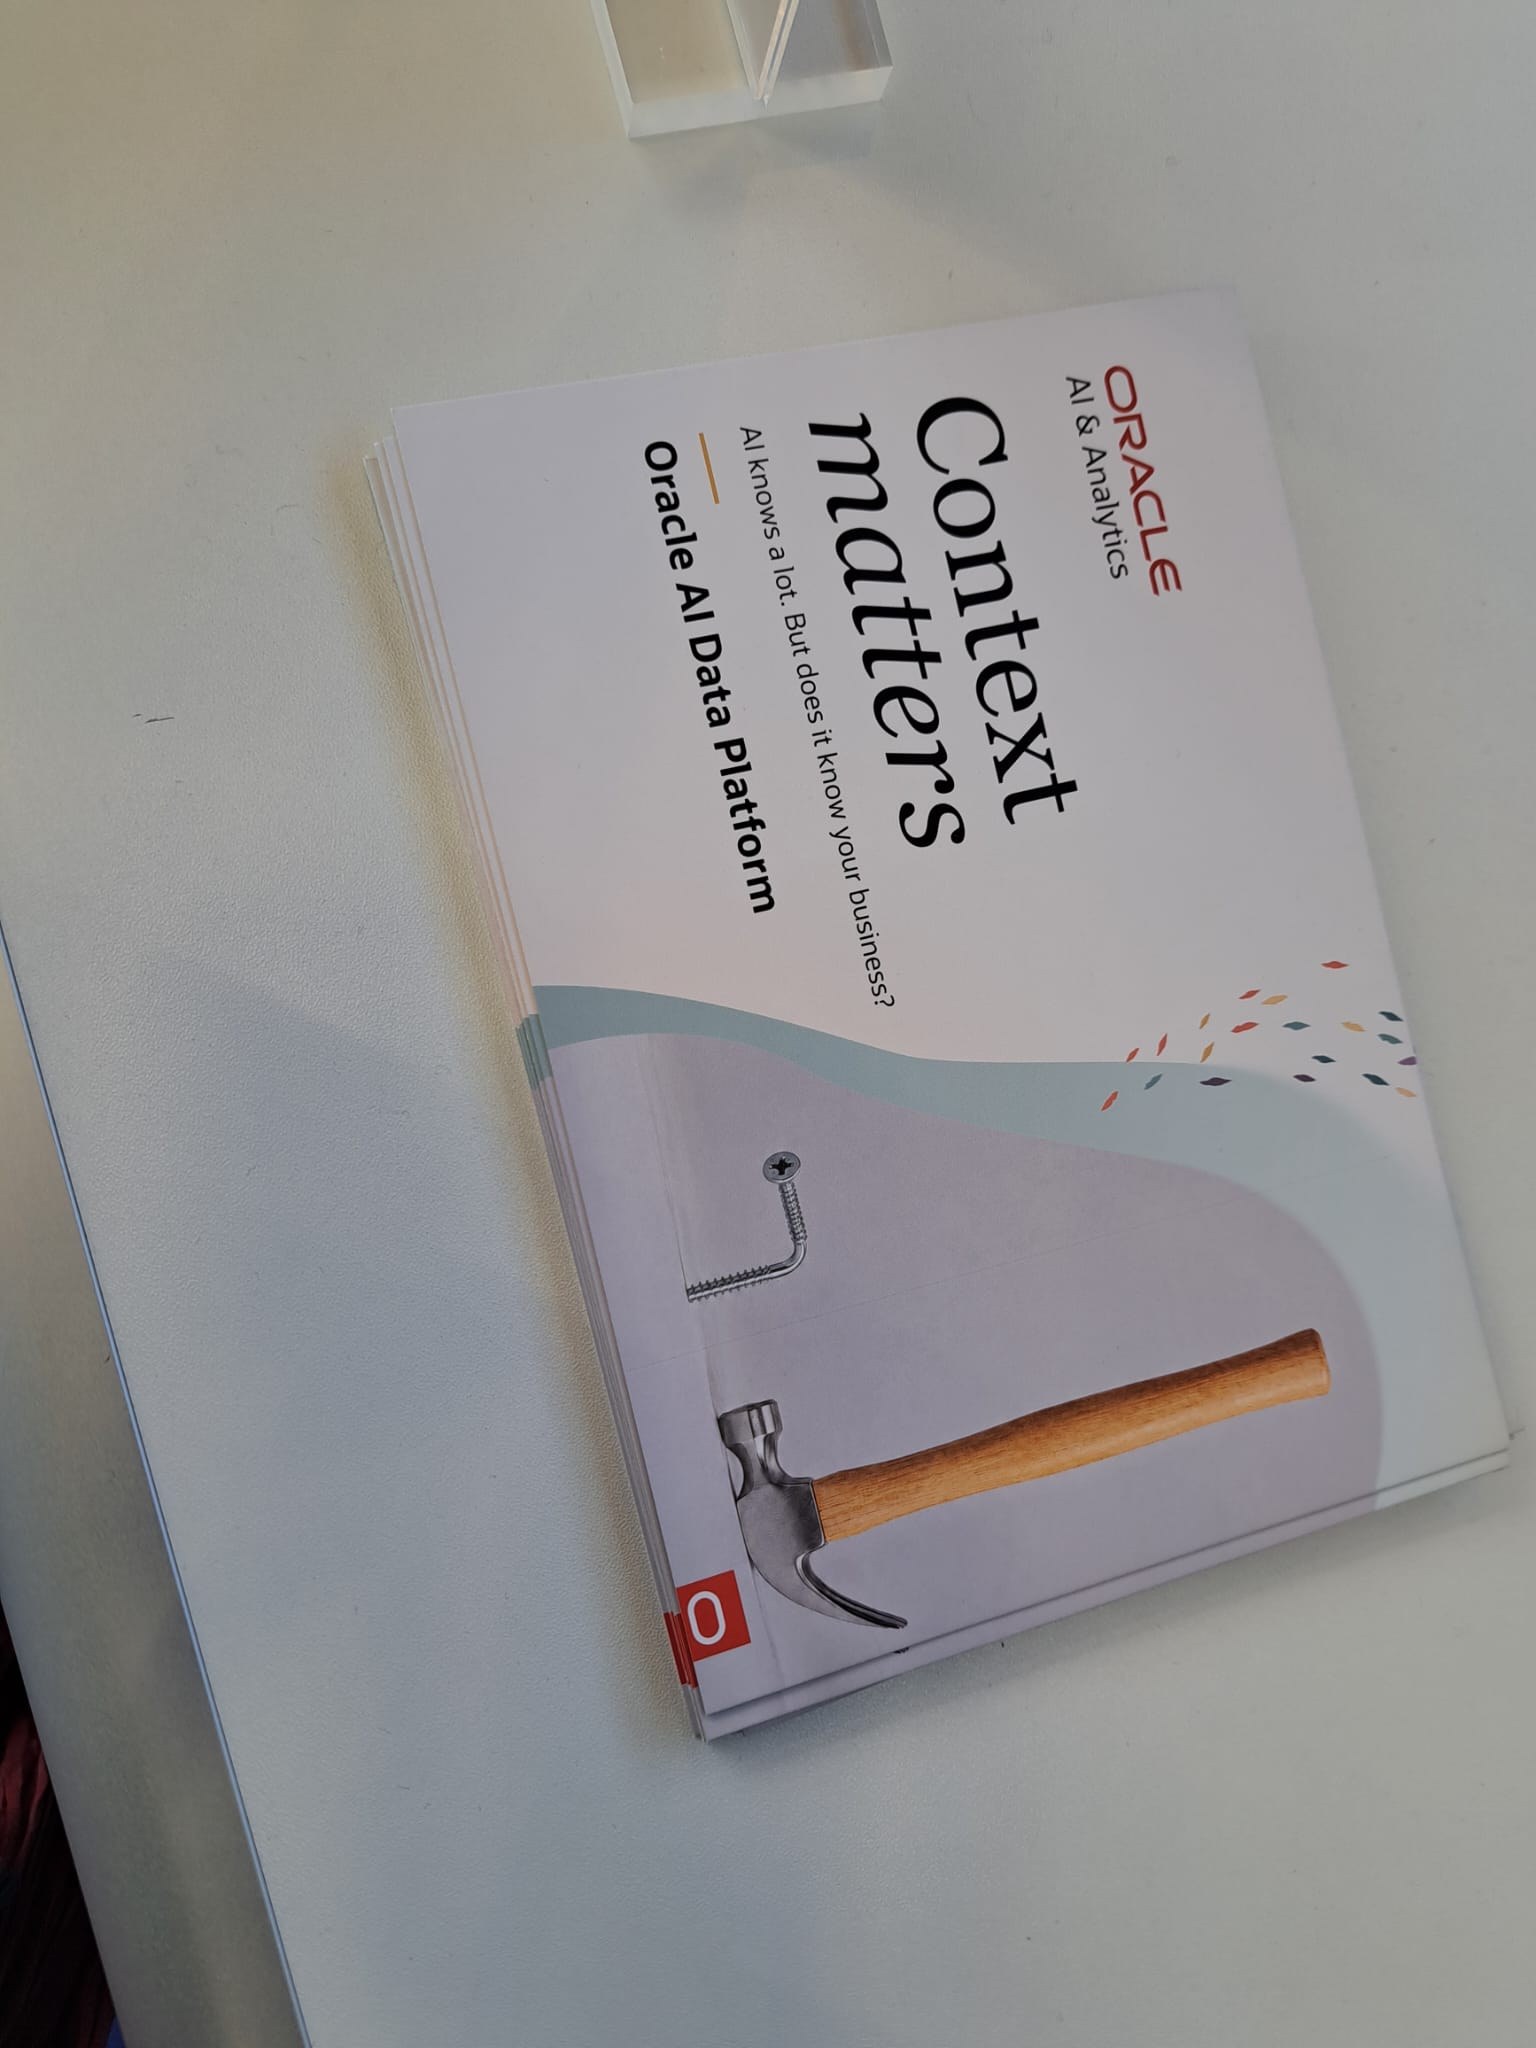
Ook bezocht ik Oracle. Bij de stand zag ik materiaal over het Oracle AI Data Platform en het belang van bedrijfscontext bij AI. Voor mij raakt dat aan een eenvoudige maar belangrijke vraag: hoe bruikbaar is een AI-toepassing als de onderliggende informatie onbetrouwbaar is of de context ontbreekt?
Ik vond het interessant om vanuit die invalshoek naar data, cloud en AI te kijken. De technische mogelijkheden zijn groot, maar de aansluiting op processen en bestaande IT-landschappen bepaalt mede de praktische waarde.
MOKOSmart trok mijn aandacht met IoT-technologie, zoals sensoren, Bluetooth-beacons, trackers en gateways. Daarmee worden fysieke objecten en omgevingen verbonden met digitale systemen. Denk aan het volgen van bedrijfsmiddelen of het meten van temperatuur en luchtvochtigheid.
Daar komen andere vragen bij kijken dan bij een scherm of een losse API: wat gebeurt er als de verbinding wegvalt, hoe betrouwbaar zijn metingen en hoe gaan apparaten om met energieverbruik? De combinatie van hardware, netwerken, software en gegevens laat mooi zien hoe breed IT is.
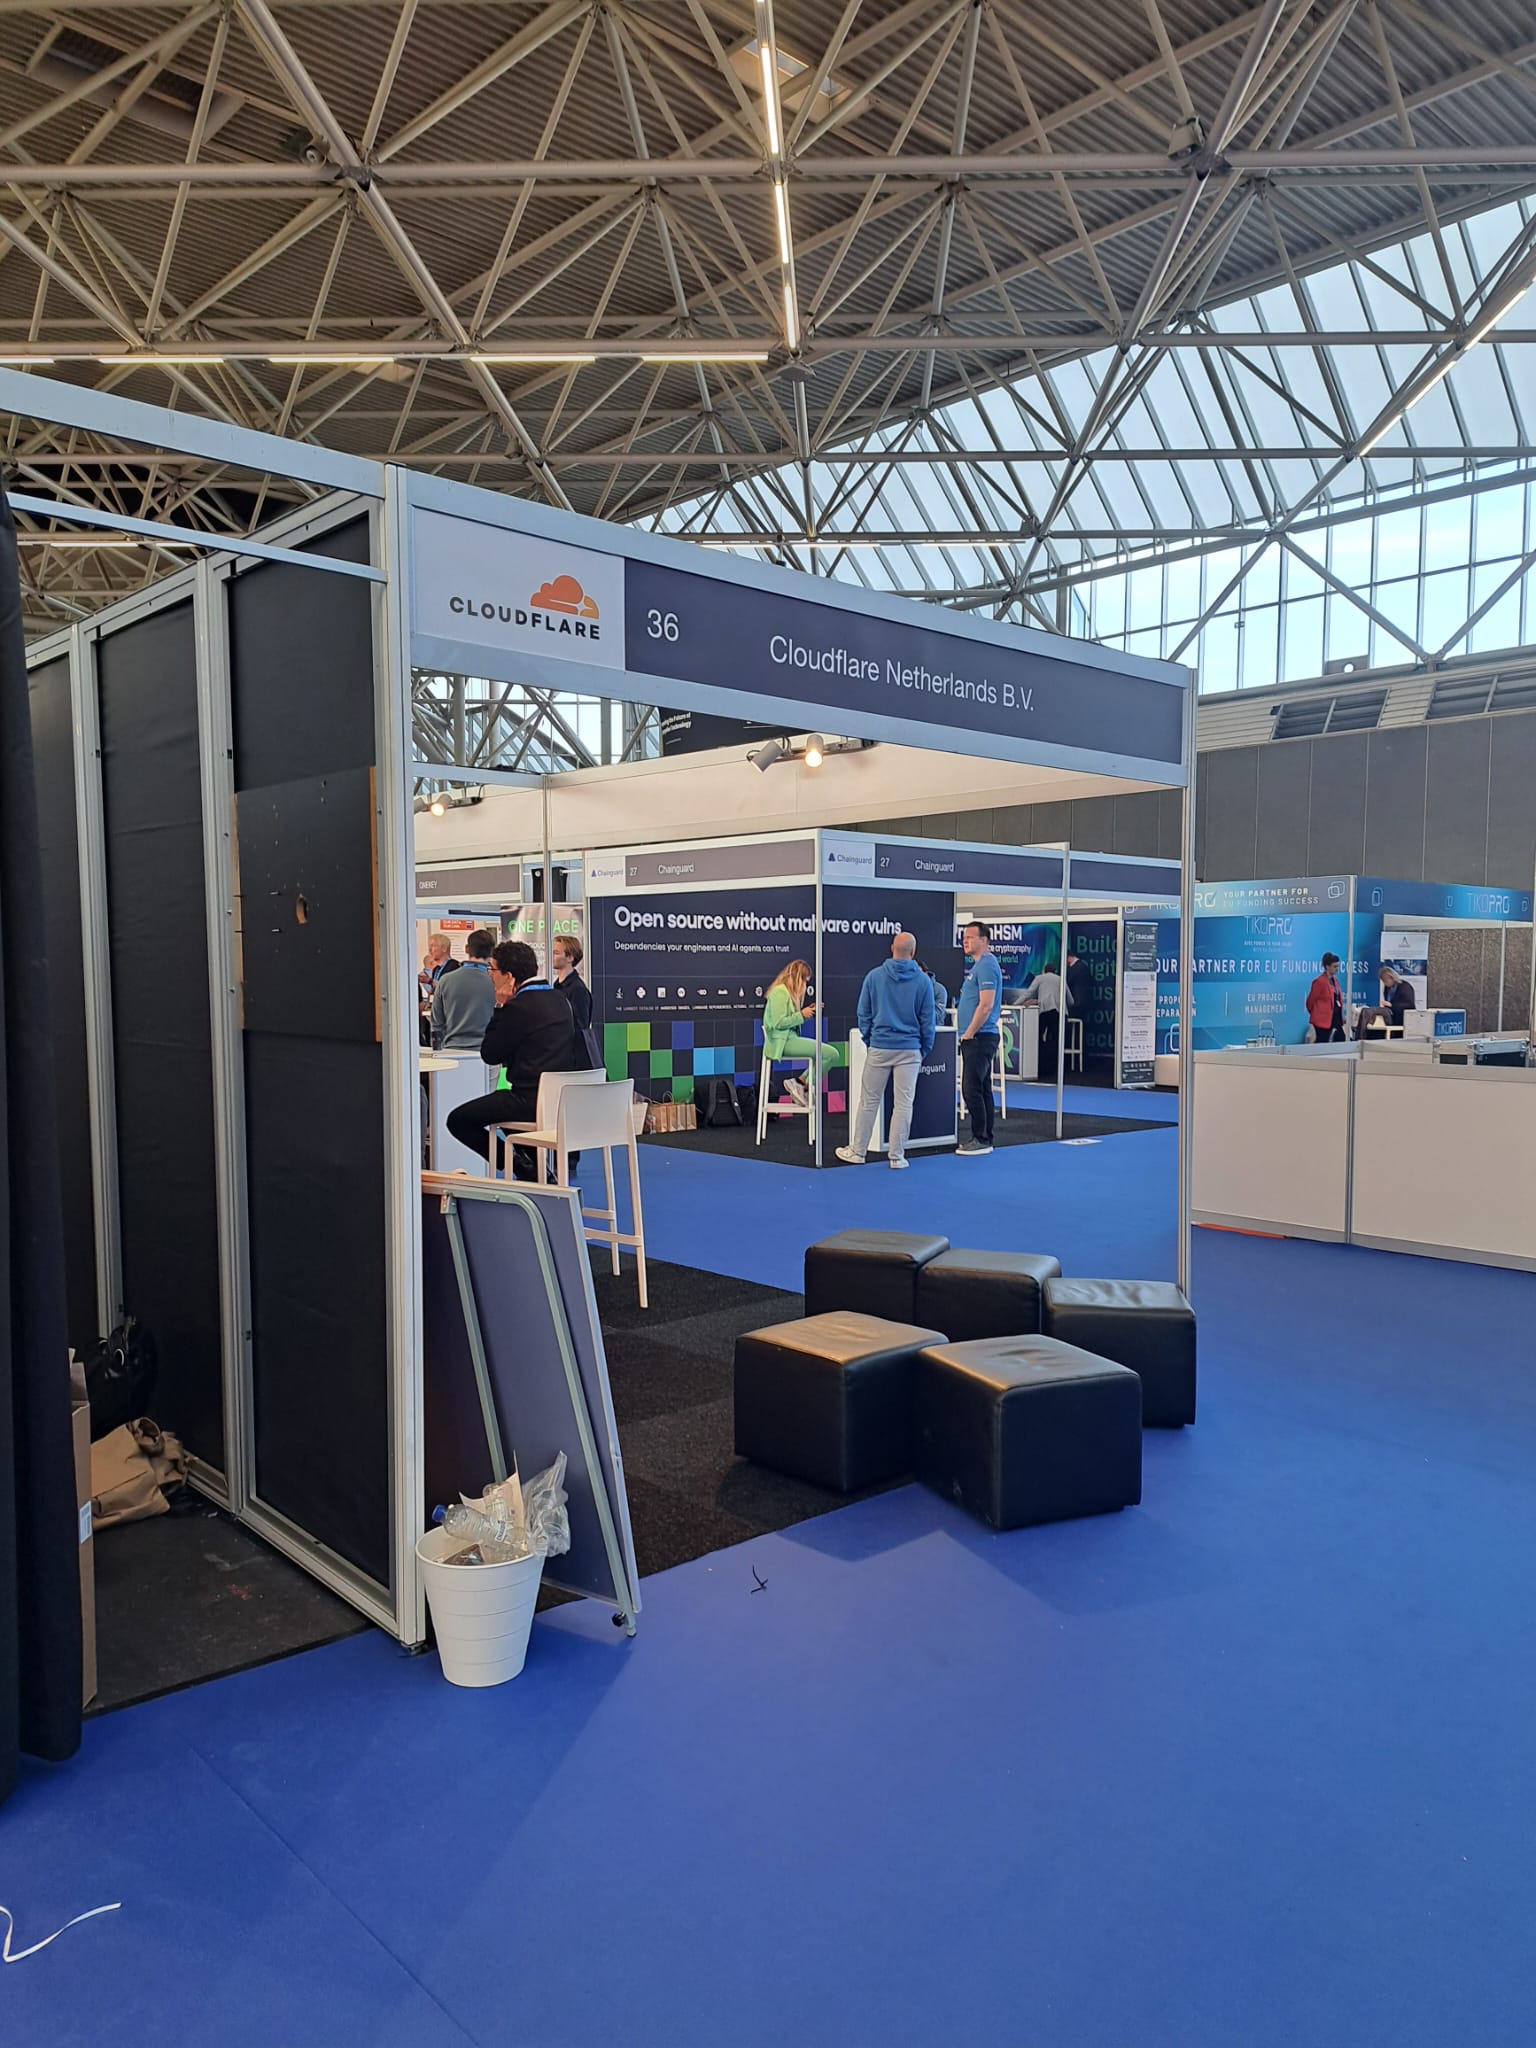
Tijdens mijn rondgang kwam ik ook Cloudflare tegen, met onderwerpen rond netwerkbeveiliging, beschikbaarheid en prestaties. Ik heb het aanbod daar niet uitgebreid onderzocht, maar de aanwezigheid sloot aan bij de bredere thema’s van de beurs.
Applicaties zijn afhankelijk van verbindingen, API’s en infrastructuur. Beveiliging en performance zijn daarom geen losse onderwerpen naast softwareontwikkeling, maar onderdelen van het geheel.
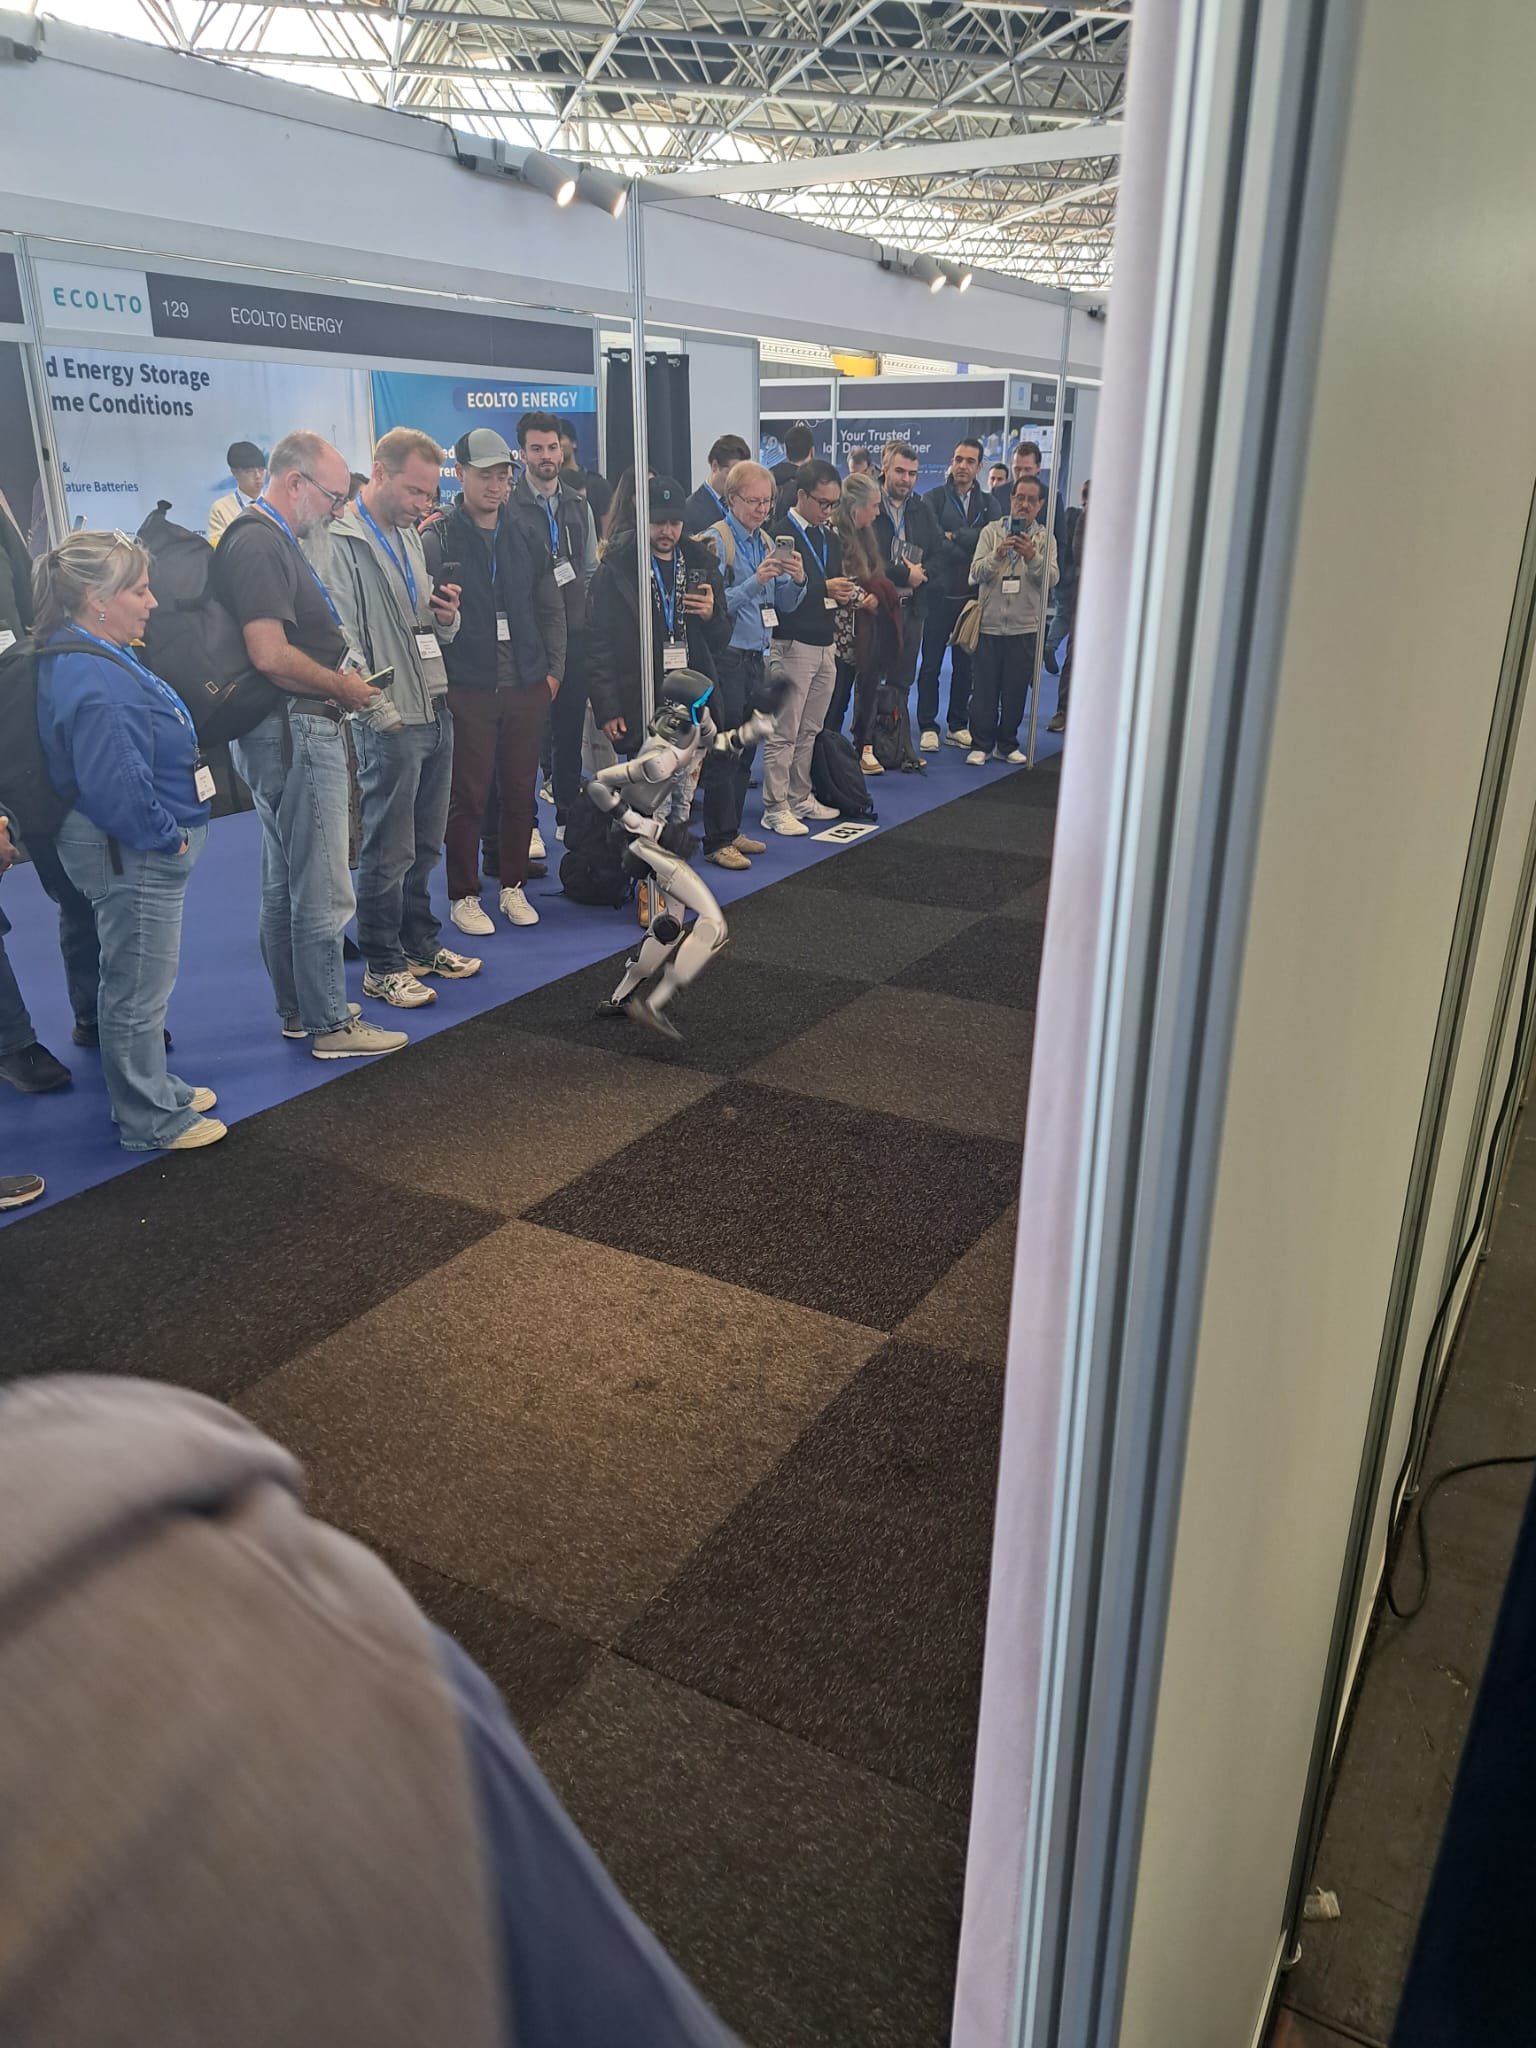
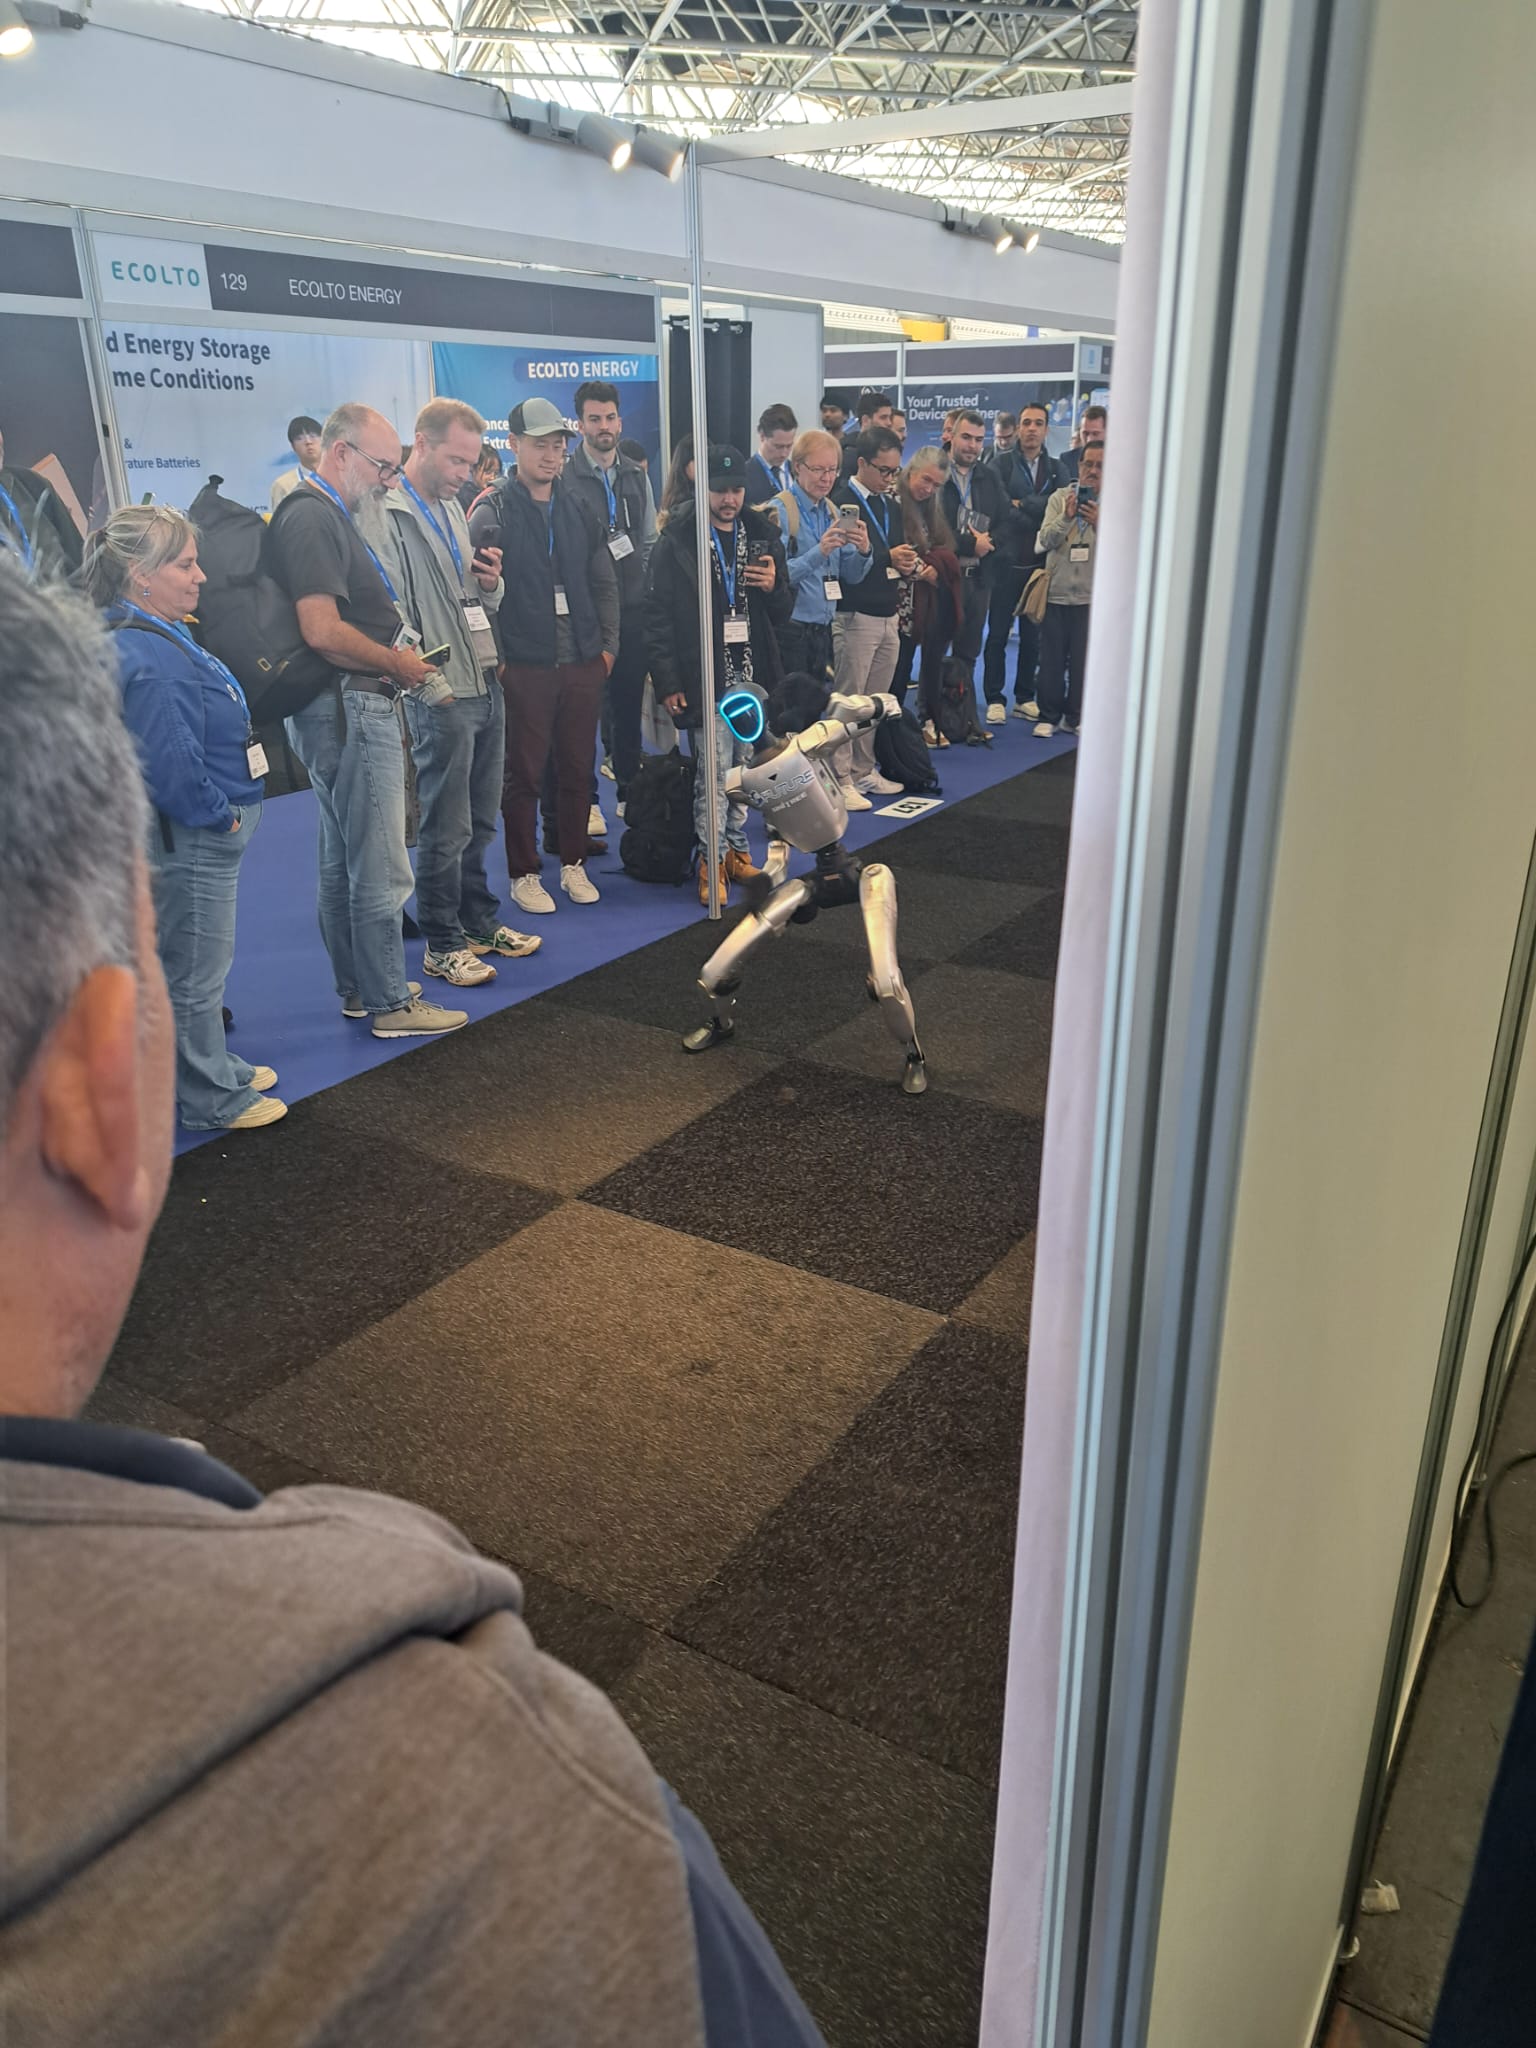
Een opvallend moment was een demonstratie met een humanoïde robot. Voor een groep bezoekers voerde de robot verschillende bewegingen uit. Het was leuk om dit daadwerkelijk op de beursvloer te zien, in plaats van alleen in een presentatie of video.
Daar komen AI, sensoren, besturingssoftware en mechanica samen. Het past bij het onderwerp Physical AI: AI die ook in fysieke systemen wordt toegepast. Vanuit mijn technische interesse vind ik vooral de samenwerking tussen al die onderdelen boeiend. Een demonstratie laat iets zien van de mogelijkheden, maar is uiteraard nog geen volledige beoordeling van de betrouwbaarheid in dagelijks gebruik.
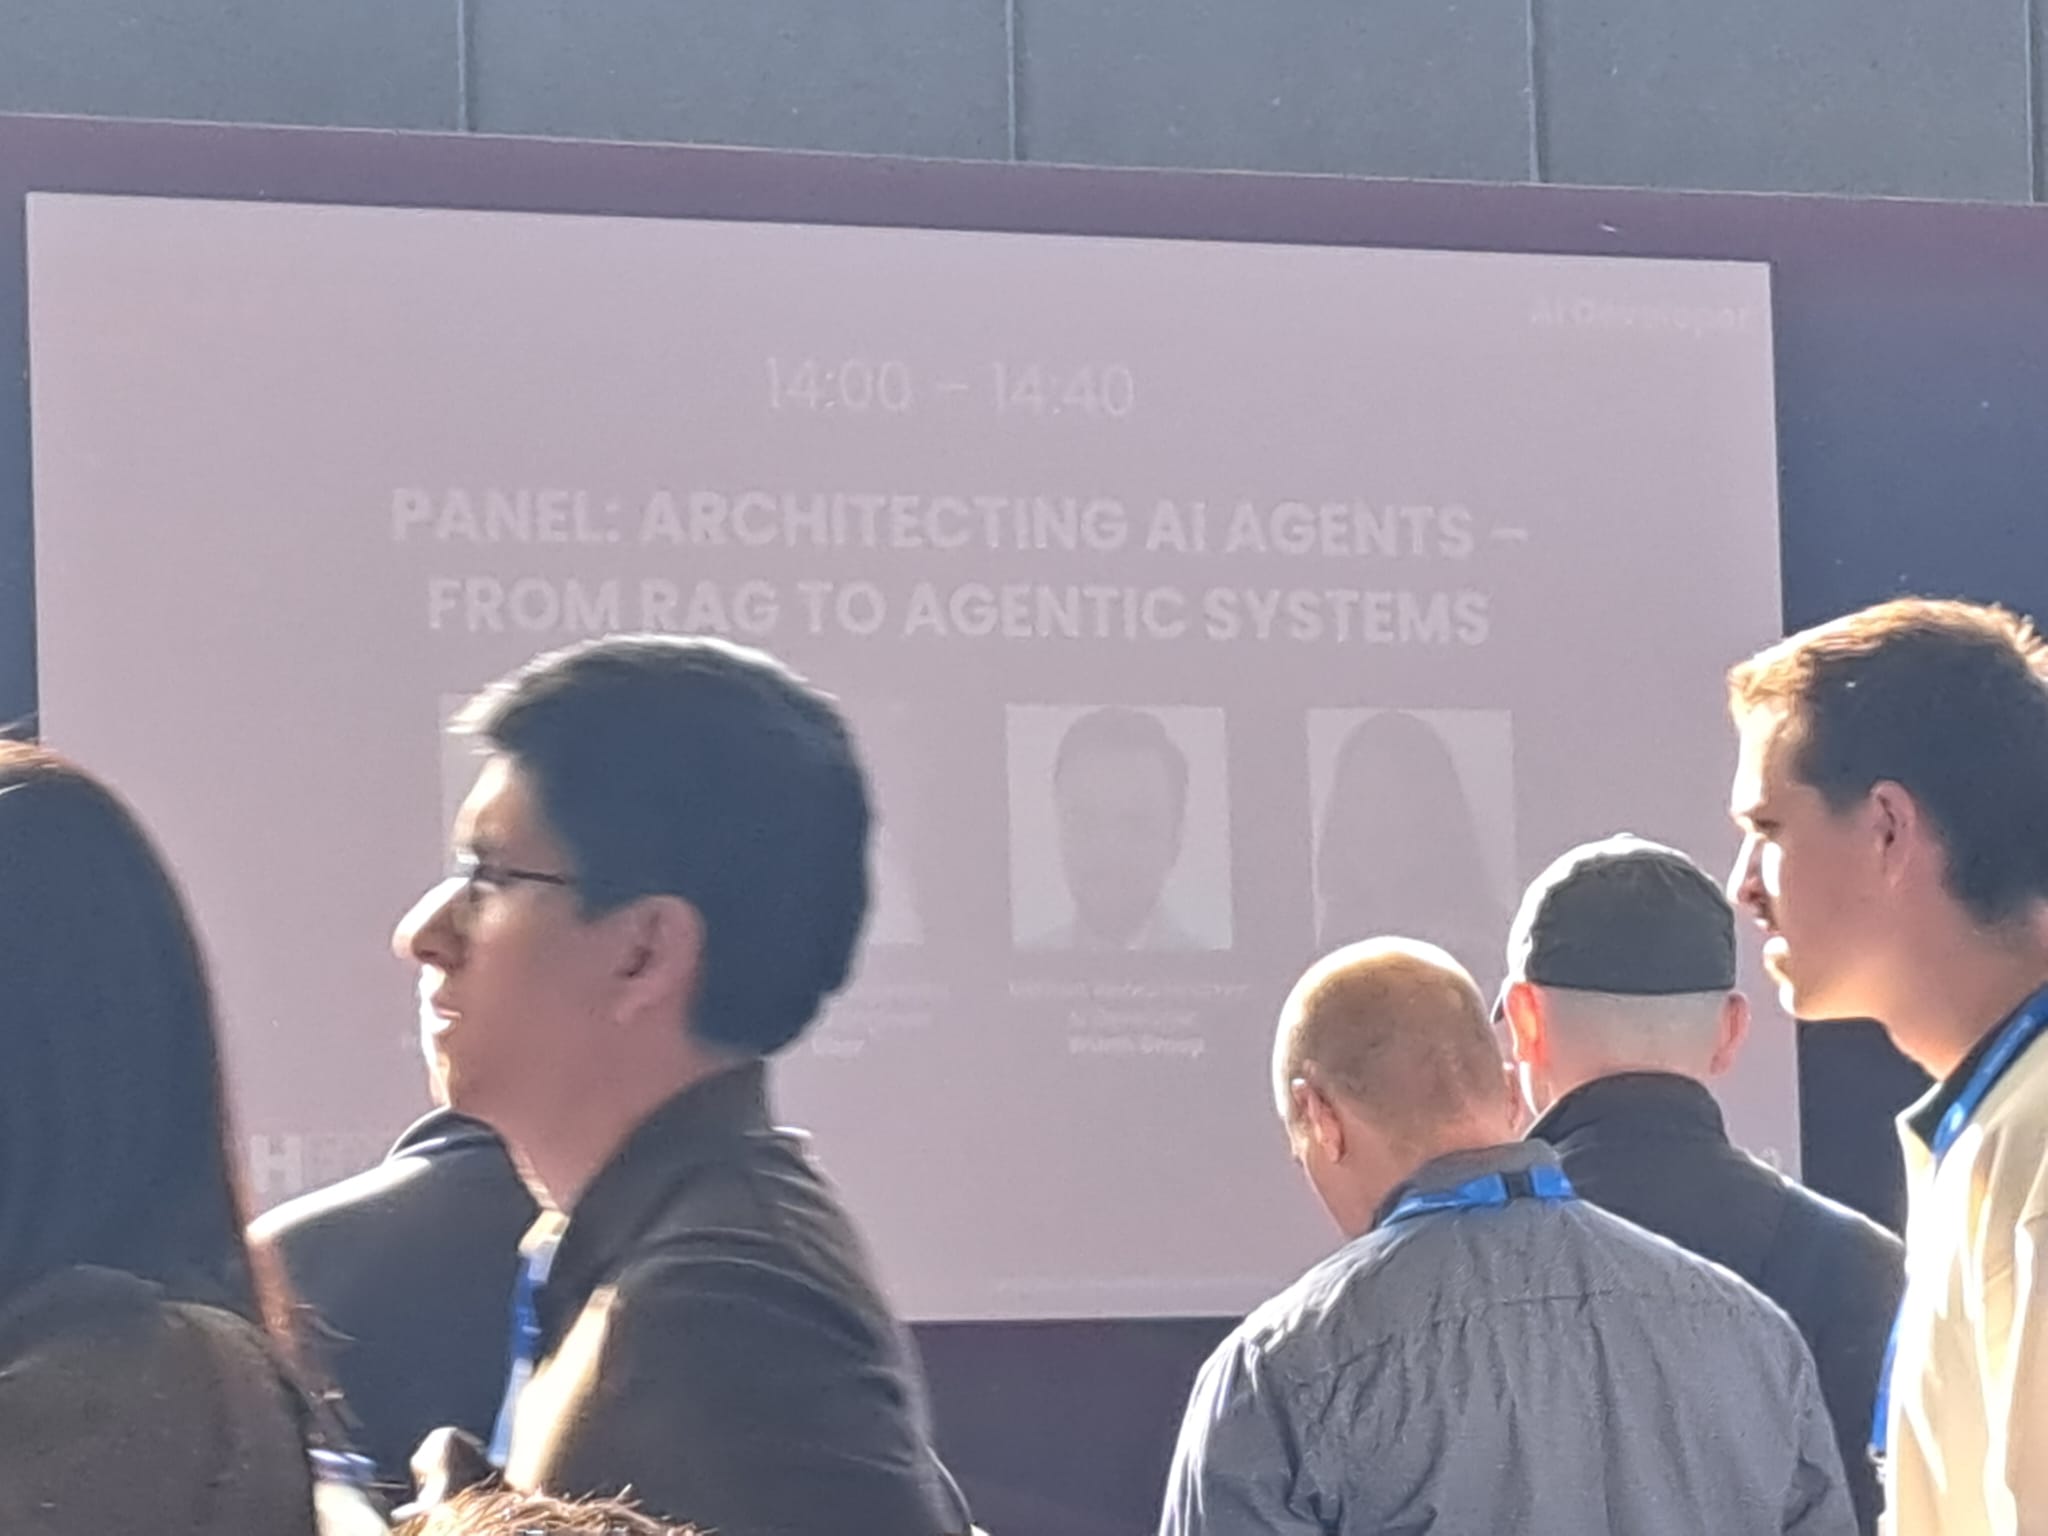
Een van de panels ging over de ontwikkeling van AI-agents. Bij Retrieval-Augmented Generation, RAG, wordt een taalmodel ondersteund met relevante informatie uit externe bronnen, zoals bedrijfsdocumentatie of een kennisbank. Bij agentic systems ligt de nadruk daarnaast op het plannen en uitvoeren van stappen, bijvoorbeeld door tools te gebruiken.
Dat biedt interessante mogelijkheden, maar roept voor mij ook vragen op. Welke acties mag zo’n systeem uitvoeren? Hoe volg je de beslissingen en hoe controleer je het resultaat als antwoorden of gekozen stappen kunnen variëren? Het zijn vragen die raken aan ontwerp, beveiliging en testen.
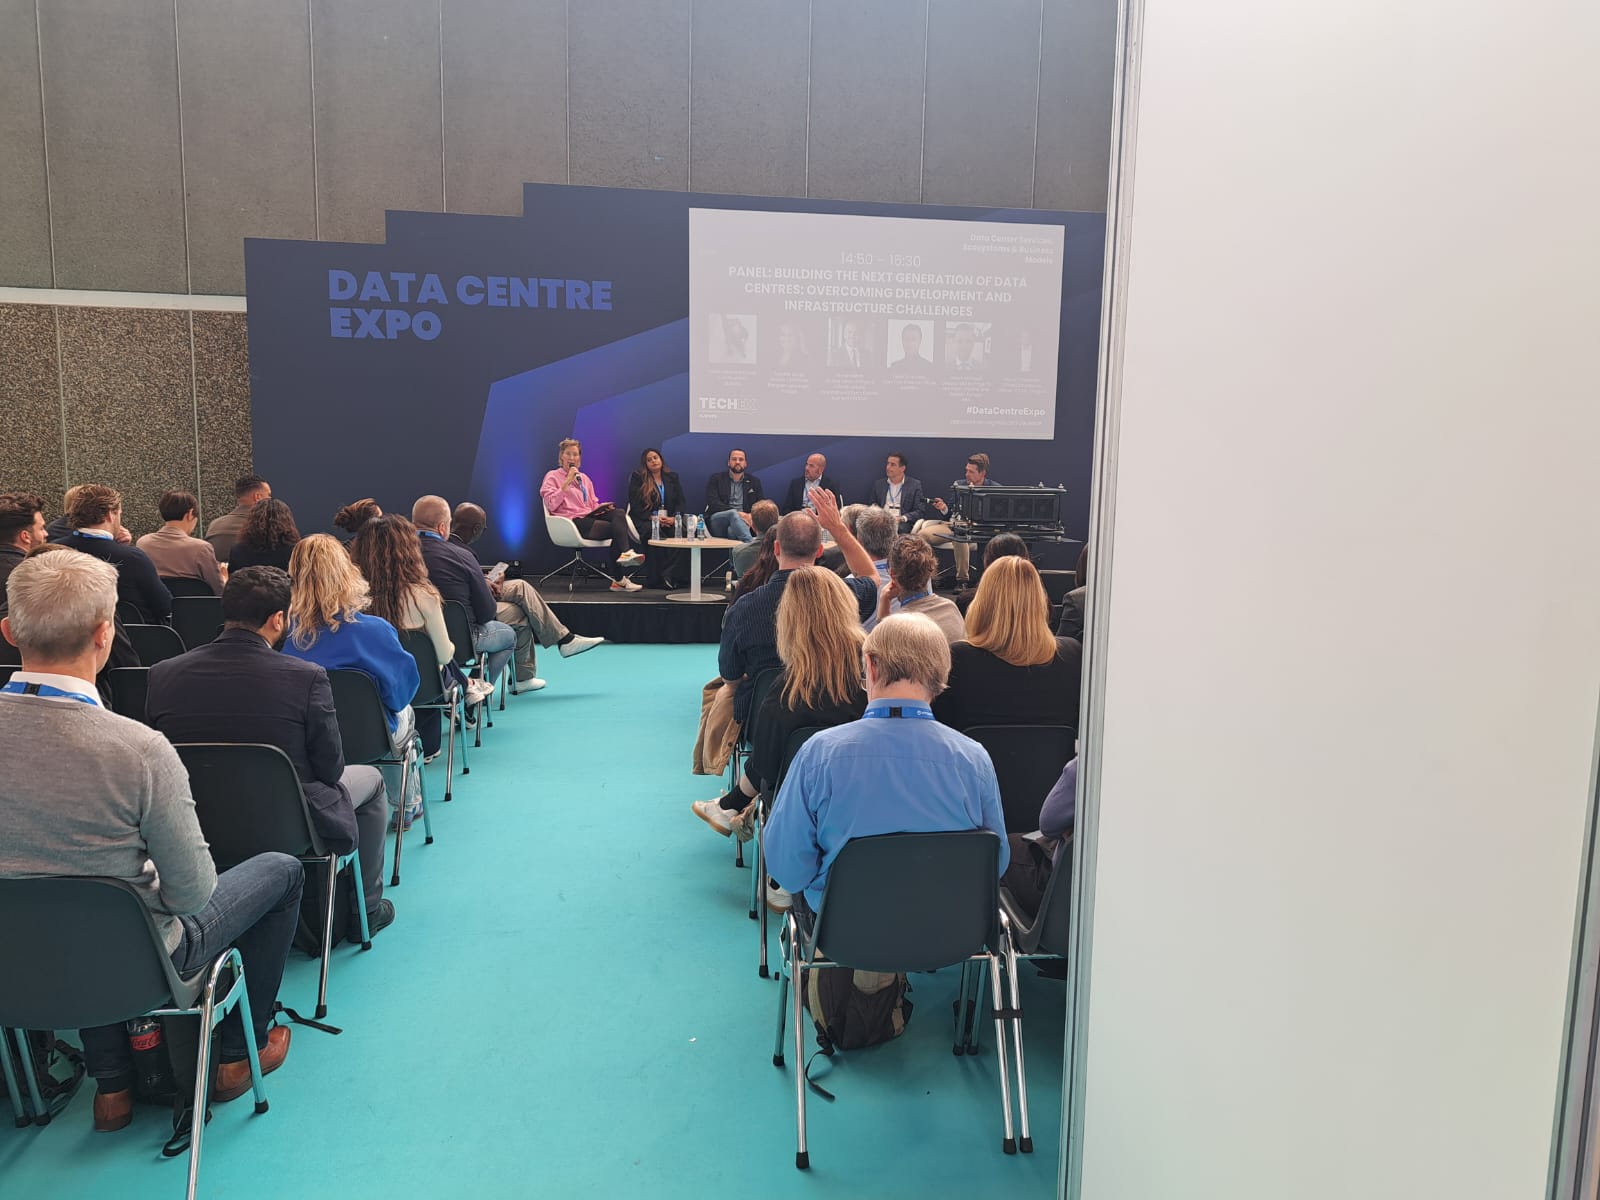
Een ander panel ging over datacenters. Achter cloud- en AI-toepassingen staat een fysieke infrastructuur met vragen rond energieverbruik, koeling, schaalbaarheid, beschikbaarheid en duurzaamheid.
Dat was een waardevolle aanvulling op alle software en AI op de beursvloer. Een digitale dienst kan nog zo slim zijn: uiteindelijk zijn er ook apparatuur, verbindingen en energie nodig om die dienst te laten werken.
Mijn bezoek was breder dan softwaretesten alleen, en juist dat vond ik waardevol. Kwaliteit ontstaat niet binnen één vakgebied. Gegevens, integraties, applicaties, beveiliging en infrastructuur beïnvloeden elkaar. Die samenhang begrijpen helpt mij om betere vragen te stellen en risico’s te herkennen.
Boomi was een vertrouwde kennismaking, de robotdemonstratie maakte technologie tastbaar en de panels brachten bredere vraagstukken in beeld. Spectrum wil ik verder onderzoeken zodra de toegezegde informatie binnenkomt. Eén beursdag was genoeg om met nieuwe ideeën naar huis te gaan, zonder te denken dat ik alle onderwerpen daarmee al volledig heb doorgrond.
Dit is mijn persoonlijke bezoekverslag. De links hieronder bieden informatie van de organisator en de genoemde leveranciers; ze zijn geen onafhankelijke productbeoordeling.
14 oktober 2026 · Testvak · Datakwaliteit · Professionele afwegingen
Het nieuws over BMS raakt aan mijn eigen ervaringen uit 2022 en 2023. Een persoonlijke terugblik op datakwaliteit, vertrouwen in een project en verantwoordelijkheid nemen voor je professionele oordeel.
Lees het artikelOp 14 oktober las ik bij de NOS dat UWV stopt met de ontwikkeling en implementatie van de Bemiddelingsservice, BMS. Dat nieuws kwam persoonlijk binnen. Ik heb in 2022 en 2023 ongeveer twee jaar aan het project gewerkt en besloot destijds zelf te vertrekken, omdat ik het vertrouwen in het project had verloren.
Zoals ik mijn periode herinner, waren we het eerste jaar vooral bezig met de database en de servicelaag, waaronder REST-API’s. Daarna volgden de aanbesteding en de aanschaf van een BMS-applicatie. In de periode daarna kregen we te maken met applicatieproblemen en problemen rond de gegevens.
Voor mij zat daar een belangrijke zorg: ik zag onvoldoende aansluiting tussen de verwerking van de data en de applicatie die daarmee moest werken. Na bijna een tweede jaar met tegenslagen was mijn vertrouwen zo ver afgenomen dat ik besloot het project achter me te laten.
Dat is mijn persoonlijke terugblik op mijn eigen werkperiode. Ik kan daarmee niet beoordelen wat er na mijn vertrek allemaal is veranderd of welke beslissingen in latere fasen zijn genomen.
Volgens de openbare toelichting van UWV speelden onder meer de benodigde gegevenskwaliteit en de technische aansluiting op de bestaande omgeving een rol. De organisatie heeft onvoldoende vertrouwen dat BMS binnen een verantwoorde termijn en tegen verantwoorde kosten kan worden ingevoerd.
UWV meldt dat sinds de start in 2021 ongeveer 55 miljoen euro aan het project is besteed. Dat bedrag betreft ook investeringen in infrastructuur. Volgens UWV kan een deel van het ontwikkelde mogelijk worden hergebruikt; de precieze omvang en waarde worden nog onderzocht. Het volledige bedrag simpelweg als verloren beschouwen zou daarom te kort door de bocht zijn.
Ik herken in die openbare toelichting thema’s die voor mij destijds al reden waren om te twijfelen. Die herkenning betekent niet dat mijn ervaringen het hele verloop verklaren. Mijn perspectief is dat van een voormalig projectmedewerker, niet dat van de evaluatie van het complete project.
Een systeem dat werkzoekenden en werkgevers beter moet helpen, heeft een doel dat ertoe doet. Als zo’n project uiteindelijk stopt, raakt dat aan de verwachtingen van mensen, de inzet van betrokken medewerkers en het zorgvuldig omgaan met publieke middelen. Dat betreur ik oprecht.
Ik hoop dat de evaluatie bruikbare lessen oplevert: over de samenhang tussen gegevens en applicaties, over tijdig toetsen of een oplossing in de praktijk werkt en over het serieus wegen van risico’s voordat de volgende stap wordt gezet.
Tegelijkertijd ben ik trots op mijn eigen handelen. Ik ben destijds niet blijven doorgaan op basis van de hoop dat het uiteindelijk vanzelf goed zou komen. Op grond van wat ik in mijn werk zag, heb ik een eigen afweging gemaakt en besloten te vertrekken.
Het nieuws van nu geeft mij vertrouwen in het oordeel dat ik toen vormde. Het blijft belangrijk om dat zorgvuldig te formuleren: ik keek vanuit mijn positie naar een deel van het project. Juist binnen dat perspectief heb ik verantwoordelijkheid genomen voor mijn eigen keuze.
Voor mij onderstreept deze ervaring dat kwaliteit niet ophoudt bij een werkende API of een geslaagde test op een afzonderlijk onderdeel. De vraag is ook of gegevens bruikbaar zijn voor de applicatie en of de hele keten het bedoelde resultaat oplevert.
Dat vraagt om kritische vragen: welke gegevens verwacht de applicatie, welke kwaliteit leveren de bronnen en wat gebeurt er met uitzonderingen? En vooral: kunnen we met realistische gegevens vroeg aantonen dat de oplossing daadwerkelijk helpt?
Dat is een lijn die ik ook in mijn testportfolio probeer vast te houden: verwachtingen zichtbaar maken, bevindingen onderbouwen en benoemen wat een testresultaat wel en niet bewijst. Soms is verder bouwen de juiste keuze. Soms vraagt professioneel handelen om opnieuw beoordelen, bijsturen of voor jezelf besluiten te stoppen.
De beschrijving van mijn werkzaamheden en vertrek is mijn eigen terugblik. De actuele projectinformatie is ontleend aan de openbare bronnen hieronder. Het AcICT-advies gaat over een latere projectfase en is geen beoordeling van mijn persoonlijke werkperiode.
13 oktober 2026 · Robot Framework · community · AI
Een terugblik op de bijeenkomst en de vraag hoe AI-gebruik en samen leren elkaar kunnen versterken.
Lees het artikelIk woonde een online bijeenkomst van de Robot Framework-community bij. Voor mij zat er weinig technische verdieping in, maar de afsluitende oproep om feedback en kennis te delen bleef hangen. Als we met AI steeds vaker zelf een oplossing vinden, hoe zorgen we dan dat de community daar ook iets aan heeft?
De bijeenkomst begon met uitleg over het format en aandacht voor een podcast. Er werd ruimte geboden voor live demo’s en samen programmeren: mogelijkheden om niet alleen te luisteren, maar ook zelf iets te laten zien en uit te proberen. Verder kwamen RoboCon en aankomende evenementen aan bod.
Ik had zelf op meer inhoudelijke verdieping gehoopt. Toch vond ik de afsluitende oproep interessant: geef feedback, breng ideeën in en deel wat je tegenkomt. Juist die uitwisseling maakt een community waardevol.
Zoals ik het gesprek begreep, merken de organisatoren dat mensen met AI vaker zelfstandig naar oplossingen zoeken. Daarbij werd ook erkend dat dit vaak sneller gaat en soms een beter resultaat oplevert. De boodschap was voor mij geen afwijzing van AI, maar een zoektocht naar een manier waarop AI-gebruik en samenwerking naast elkaar kunnen blijven bestaan.
Dat herken ik. Ook bij het bouwen van deze website helpt AI me om dingen uit te zoeken en verder te komen. Maar een oplossing die voor mij werkt, wordt niet vanzelf gedeelde kennis. Wanneer ik alleen het antwoord gebruik en daarna verderga, weet de community niet welk probleem ik had, wat hielp en wat misschien verbeterd kan worden.
Een framework bestaat niet alleen uit de code die ik vandaag gebruik. Er zit werk achter van mensen die het ontwikkelen, onderhouden, uitleggen en in de praktijk toepassen. Door ervaringen te delen, kunnen anderen daarvan leren en kunnen terugkerende problemen zichtbaar worden.
Mijn vraag na deze bijeenkomst is daarom: hoe blijft die uitwisseling aantrekkelijk als een AI-assistent het eerste aanspreekpunt wordt? Voor mijn gevoel raakt dat aan de meerwaarde van een community. Het gaat om een balans tussen de snelheid van een individueel antwoord en de kennis die we gezamenlijk opbouwen.
Voor mij hoeft dat niet te betekenen dat ik minder AI moet gebruiken. Ik kan wel bewuster iets teruggeven: een bruikbare oplossing delen, een fout melden, feedback geven of laten zien hoe ik een demo heb gebouwd. Een AI-antwoord kritisch controleren en mijn bevindingen vervolgens delen, kan juist een aanleiding zijn voor een goed gesprek.
De bijeenkomst was voor mij niet bijzonder boeiend qua techniek, maar leverde wel een relevante vraag op: als ik profiteer van een framework en de kennis eromheen, hoe draag ik dan bij aan het samen verder leren?
Dit is mijn persoonlijke terugblik op de bijeenkomst, op basis van mijn eigen aantekeningen. De beschrijving van het gesprek en mijn interpretatie zijn geen letterlijk verslag of officiële verklaring van de organisatoren.
30 september 2026 · DevOps · CI/CD · kwaliteitsbewaking
Hoe teamcontroles en gedeeld testbewijs inzicht geven in de kwaliteit van een DevOps-landschap.
Lees het artikelTijdens een DevOps-vakgroepevent bij mijn werkgever woonde ik een lezing bij over certified pipelines met GitHub Enterprise. Wat me vooral bijbleef, was het gezamenlijke doel: per applicatie zichtbaar maken of de ontwikkel- en publicatieketen aan een afgesproken norm voldoet. Elk team levert daarvoor zijn eigen controles en bewijs aan, zodat er op organisatieniveau een overzicht ontstaat.
GitHub Enterprise ondersteunt organisaties bij het beheren van broncode en samenwerken aan wijzigingen. Teams werken met repositories, versiebeheer, pull requests en reviews. Enterprise-beheer voegt centrale mogelijkheden toe voor toegang, beleid en controle over meerdere organisaties. GitHub biedt hiervoor zowel een cloudvariant als een zelf beheerde servervariant.
Met GitHub Actions kunnen teams workflows uitvoeren voor bijvoorbeeld bouwen, testen en publiceren. De stappen worden beschreven in YAML: een leesbaar configuratieformaat waarin staat wanneer een workflow start en welke jobs uitgevoerd worden. Herbruikbare workflows helpen om gemeenschappelijke controles op meerdere projecten toe te passen.
In mijn terugblik gebruik ik deze term voor pipelines die worden beoordeeld tegen een afgesproken interne norm. Die norm beschrijft welke controles nodig zijn en welk bewijs daarvan beschikbaar moet zijn. De precieze criteria hangen af van de organisatie en het risico van de applicatie; het gaat hier niet om een automatisch verkregen GitHub-certificaat.
Denk als algemene voorbeelden aan codebeoordeling, geautomatiseerde tests, beveiligingscontroles, beheerde toegang en aantoonbare publicatiestappen. Dit zijn voorbeelden om het idee uit te leggen, geen opsomming van de concrete norm van mijn werkgever.
De aanpak die ik uit de lezing meenam, draait om één centraal YAML-bestand dat per project of applicatie de beoordeling tegen de norm ondersteunt. Zo krijgt de organisatie een gemeenschappelijk vertrekpunt: welke eisen gelden, welke controles zijn beschikbaar en waar ontbreken nog onderdelen?
YAML is daarbij de beschrijving. De scripts, workflows en achterliggende tools voeren de controles uit en leveren resultaten. GitHub Actions ondersteunt herbruikbare workflows, waarmee een centrale aanpak kan worden toegepast zonder dat elk team dezelfde logica opnieuw hoeft te schrijven. Hoe het centrale bestand precies is ingericht, bepaalt de organisatie zelf.
Een centraal overzicht vraagt om betrouwbare informatie vanuit de teams. Zij kennen hun applicatie en richten de passende checks and balances in: controles, reviews, bevoegdheden en opvolging van afwijkingen. De centrale norm helpt om die inspanningen in dezelfde taal te beoordelen, terwijl teams verantwoordelijk blijven voor de kwaliteit van hun eigen keten.
Het interessante is de verbinding tussen twee niveaus. Binnen een team wil je weten of een wijziging veilig door de pipeline gaat. Over het landschap heen wil je zien hoe consequent de afspraken worden toegepast en waar verbetering nodig is. Ontbrekend bewijs, een mislukte controle en een bewust vastgelegde uitzondering verdienen daarbij ieder een eigen verklaring.
Een groen overzicht is een bruikbaar signaal: de geselecteerde controles zijn uitgevoerd en voldeden aan hun criteria. Het zegt nog niet dat een applicatie foutloos is of dat alle risico’s zijn onderzocht. Ook de inhoud, actualiteit en dekking van de controles moeten kritisch bekeken worden. Juist daar zie ik een belangrijke rol voor softwaretesters.
Voor mij maakt deze aanpak volwassenheid bespreekbaar. Je kunt gericht vragen stellen: welke norm gebruiken we, welk bewijs hebben we en welk risico blijft over? Het wordt daarmee meer dan een verzameling losse teams die ieder hun eigen vinkjes zetten; hun werk draagt bij aan één gezamenlijk doel.
Op kleinere schaal probeer ik dezelfde gedachte op deze website toe te passen. Ik beheer code met Git, test vóór publicatie, koppel testbewijs aan de geselecteerde bestanden en bewaak later de ontvangen testresultaten. Mijn site gebruikt hiervoor een lokaal publicatieproces en NAS-taken. De lezing helpt me vooral nadenken over de volgende vraag: hoe maak je kwaliteitsafspraken aantoonbaar en houd je het overzicht begrijpelijk?
Dit artikel is mijn algemene terugblik op de lezing, zonder interne configuraties of bedrijfsinformatie. De uitleg over GitHub is gebaseerd op de officiële documentatie:
Mijn persoonlijke leerroute
Mijn website als leeromgeving: begrijpen wat ik heb gebouwd, hoe de onderdelen samenwerken en waarom de techniek zo is ingericht.
Vanuit mijn werk als Test Engineer en Test Automation Specialist heb ik ervaring met softwaretesten en testautomatisering. Daarnaast heb ik kennis van SQL, Python en Java. Hier verdiep ik me vooral in HTML, CSS, JavaScript, PHP en Git, steeds aan de hand van mijn eigen website. Ik hoef niet iedere regel uit mijn hoofd te kennen; ik wil het proces goed kunnen uitleggen, relevante code herkennen en gevolgen van wijzigingen kunnen beredeneren.
Opzet: 22 leerdoelen met 66 toetsbare acceptatiecriteria, van browser en backend tot deployment en testbewaking.
Werkwijze: lees de bestaande ontwerpdocumentatie, volg een concrete functie in de code en toon per leerdoel je begrip aan met de bewijsopdracht.
Beoordeling: behaalde resultaten worden hieronder per leerdoel gepubliceerd. Het gaat om een persoonlijke leerroute met zelfontwikkelde toetsen: resultaten worden door mij geregistreerd en zijn geen onafhankelijke certificering. De website beoordeelt op dit moment nog geen toetsantwoorden automatisch.
De vragen gaan over deze implementatie en toetsen begrip, code lezen, foutdiagnose en het voorspellen van gedrag. Bijvoorbeeld: welke versie wordt gepubliceerd, wat gebeurt er bij een foutstatus, of waarom blijft een planningmelding staan? Alleen een term herkennen is onvoldoende: je moet je antwoord kunnen onderbouwen.
Per leerdoel beoordelen we de drie criteria afzonderlijk. Een fout antwoord laat zien wat opnieuw bestudeerd moet worden. Een definitieve toetsvorm en slaaggrens bepalen we later. We oefenen met lokale of fictieve gegevens; voor deze leerroute hoef je geen productiegegevens te verwijderen.
De huidige Robot-suite en PHP-syntaxcontroles beoordelen de software, niet automatisch jouw kennis. Deze persoonlijke leerroute wordt daarom apart getoetst.
Geen toetsresultaten geladen in deze statische versie.
Praktijk: Home, index.php en de lokale PHP-server.
Aantonen met: Teken de route van één Home-request en benoem minstens drie verschillen tussen lokaal en productie.
Geen toetsresultaten geladen in deze statische versie.
Praktijk: index.php: Home, navigatie en toegangscodeformulier.
Aantonen met: Wijs de koppeling van de code-label, het invoerveld en het ontvangende PHP-bestand aan; leg ook één uitklapbaar details/summary-onderdeel uit.
Geen toetsresultaten geladen in deze statische versie.
Praktijk: index.php: responsive opmaak en Changelog.
Aantonen met: Inspecteer de versietekst en één mobiele layoutregel in de browserontwikkelaarstools; beschrijf wat CSS wel en niet verandert.
Geen toetsresultaten geladen in deze statische versie.
Praktijk: Dobbelsteenapp: rolkeuze, worp en reset.
Aantonen met: Volg één worp van klik naar resultaat en wijs een event-handler en DOM-mutatie aan; benoem welke toestand reset wist.
Geen toetsresultaten geladen in deze statische versie.
Praktijk: Rollende dobbelstenen, demo-bug en Stop het dobbelen.
Aantonen met: Wijs in de actuele code de start en stop van herhaalde worpen aan en ontwerp één assertion die niet te vroeg kijkt.
Geen toetsresultaten geladen in deze statische versie.
Praktijk: NAW ophalen, browserchecks en testbriefje.
Aantonen met: Bekijk één request in het Network-tabblad en noteer methode, URL, status, responseformaat en zichtbare vervolgstap.
Geen toetsresultaten geladen in deze statische versie.
Praktijk: index.php, portal_auth.php en login.php.
Aantonen met: Volg één paginaopbouw en één afgeschermd endpoint; beschrijf wat een niet-ingelogde gebruiker bij beide ontvangt.
Geen toetsresultaten geladen in deze statische versie.
Praktijk: Portaal-login en beheer-POSTs.
Aantonen met: Traceer één geautoriseerde POST; benoem wat er bij ontbrekende login en ongeldig CSRF-token moet gebeuren zonder productiegegevens te wijzigen.
Geen toetsresultaten geladen in deze statische versie.
Praktijk: document_access_store.php en document_toegang.php.
Aantonen met: Maak een toestandenschema voor CV-toegang, inclusief verlopen en al verbruikt; wijs de servercontrole vóór downloaden aan.
Geen toetsresultaten geladen in deze statische versie.
Praktijk: NAW-stub, dobbelsteen-API en testtrofee.
Aantonen met: Vergelijk één NAW-request en één JSON-request; formuleer per request minstens één status- en één inhoudsassertion.
Geen toetsresultaten geladen in deze statische versie.
Praktijk: CSV, prijs_assertions.js en de Postman-collectie.
Aantonen met: Traceer twee CSV-rijen tot twee requests en twee resultaten; ontwerp één geldige en één ongeldige testcase op basis van het actuele contract.
Geen toetsresultaten geladen in deze statische versie.
Praktijk: log_demo_bug.php, portal_data.php en de privémap foutmeldingen.
Aantonen met: Volg één demo-bug tot de privé-XML, licht de timestamp en status toe en verklaar de beveiligde lees- en mutatieroute via het portaal.
Geen toetsresultaten geladen in deze statische versie.
Praktijk: WebsiteOntwikkeling en de eerste commits.
Aantonen met: Toon bij een oefenwijziging de status vóór add, na add en na commit; interpreteer een schone werkmap en een LF/CRLF-waarschuwing.
Geen toetsresultaten geladen in deze statische versie.
Praktijk: website_lokaal.py: stappen 02 en 03.
Aantonen met: Traceer één testuitvoering en wijs aan waar rapporten ontstaan; verklaar waarom 23 groene basiscontroles geen volledige testbewaking-ketentest zijn.
Geen toetsresultaten geladen in deze statische versie.
Praktijk: testbewijs.json en de drie hashmomenten.
Aantonen met: Lees een lokaal testbewijs en traceer index.php door de drie controles; beschrijf het verschil tussen testresultaat en kopieerbewijs.
Geen toetsresultaten geladen in deze statische versie.
Praktijk: publicatiebestanden.txt en stap 04.
Aantonen met: Volg de al uitgevoerde herstelproef aan de hand van de uitvoer; ontwerp een test voor verkeerd doelpad zonder opnieuw productie te verstoren.
Geen toetsresultaten geladen in deze statische versie.
Praktijk: Laptop-Robot, NAW-runner en NAS-verzameljob.
Aantonen met: Teken de twee teststromen tot het Testdashboard en plaats de derde job op de juiste plek; beschrijf een scenario met een lopende Robot-uitvoering.
Geen toetsresultaten geladen in deze statische versie.
Praktijk: Testdashboard, testbriefje, JSON-planning en foutmeldingen.
Aantonen met: Werk op papier drie situaties uit: recente geslaagde run, recente gefaalde run en ontbrekende run; geef per situatie de verwachte relevante signalen.
Geen toetsresultaten geladen in deze statische versie.
Praktijk: Dobbelsteenrollen, browsercheck en gerichte API-uitkomsten.
Aantonen met: Maak een kleine dekkingsmatrix voor API-uitkomst, aantal zichtbare dobbelstenen, animatie en rol; motiveer per rij de testlaag.
Geen toetsresultaten geladen in deze statische versie.
Praktijk: Use cases, beheerinventaris, documentatie, quiz en Tester Quest.
Aantonen met: Kies één echte websitefunctie en maak een beknopte traceerbare testcasus: risico → scenario → verwachte uitkomst → bewijs; benoem één bewust niet geteste grens.
Geen toetsresultaten geladen in deze statische versie.
Praktijk: De berichtenservice, het JMeter-testplan, lokale en NAS-metingen en de onafhankelijke opslagcontrole.
Aantonen met: Licht een werkelijk uitgevoerde opdracht toe, wijs de betrokken onderdelen in het JMX aan en volg één geaccepteerde bericht-ID tot het JSON-bestand. Verklaar waarom de limiettest met vijf afwijzingen kan slagen en benoem twee conclusies die de metingen niet bewijzen. Een geslaagde JMeter-run is niet automatisch een afgerond leerdoel.
Geen toetsresultaten geladen in deze statische versie.
Praktijk: Mijn berichtenlimiet-API, de tokenhulpmiddelen op mijn laptop en de privébestanden op mijn NAS.
Aantonen met: Teken de keten en wijs per stap het betrokken bestand aan. Licht een aanvraag en response toe met afgeschermd token, onderbouw het verschil tussen 200, 400 en 401 en voorspel wat gebeurt als de limiet wordt verlaagd terwijl al berichten zijn ontvangen. Laat in een testomgeving zien dat een nieuw token werkt en het vervangen token wordt geweigerd. Een geslaagde softwarecontrole rondt dit leerdoel niet automatisch af.
Deze leerdoelen volgen de huidige website en eerste deploymentopzet. Als de software verandert, passen we de betrokken doelen en toetsvragen aan. SQL en een database vallen buiten deze route omdat de website geen database gebruikt; Java-ontwikkeling valt eveneens buiten de huidige implementatie.
Ik volg bijeenkomsten over softwaretesten, testautomatisering en Robot Framework. De automatische agenda en mijn aanwezigheidsregistratie horen bij de volledige versie. Deze statische pagina haalt geen actuele agenda op.
TestNet · bijeenkomstenRobot Framework · communityRoboConEen idee voor een testdemo of een suggestie vanuit het testvak? Je kunt me bereiken via LinkedIn. Het berichtenformulier is in deze statische versie niet beschikbaar.
Bekijk mijn LinkedIn ↗Een portfolio dat blijft groeien
Dit testportfolio is in ontwikkeling. Hieronder staan de gebundelde verbeteringen per release: wat is veranderd, wat is gecontroleerd en waar nog beperkingen gelden. Versie 0.2 bouwt voort op de eerste opzet van 0.1.
Kleine stappen, zichtbaar vooruit
Ook deze digitale speeltuin heeft een backlog. Vanuit mijn werk in een DevOps-team en mijn behaalde certificaten neem ik ideeën uit Agile en Scrum mee naar deze website. Hier zie je wat ik wil verbeteren, wat op de planning staat en waaraan ik werk. Geen groot releasebureau: gewoon post-its, kleine stappen en testen voordat iets klaar is.
Dit bord is een speelse blik op mijn werkwijze, geen volledige Scrum- of SAFe-implementatie. De kaartjes verander ik vanuit mijn beheerportaal. Een kaartje verschuiven publiceert geen software; wijzigingen aan de website blijven via mijn deploymentproces lopen.
Ontwikkelbord laden…
Het ontwikkelbord wordt in de volledige versie vanuit het privéportaal beheerd. De releasebeschrijvingen hieronder blijven als naslag beschikbaar.
Versie 0.2 · Portfolio in ontwikkeling
Zeven verbeteringen gebundeld
Release 0.2 maakt dit portfolio overzichtelijker en het beheer beter navolgbaar. Een ontwikkelbord toont ideeën en voortgang. De projecten zijn per testdiscipline ingedeeld, met een startroute, bewijslabels en begripsuitleg. Achter de schermen is het publicatieproces uitgebreid met een online smoketest, een optionele automatische test- en publicatieketen en inhoudsversies voor JavaScript.
De rode draad is aantoonbaarheid: zichtbaar maken wat is gebouwd, wat is gecontroleerd en welke beperkingen nog gelden. Eén centrale Robot-testbron voorkomt dubbele kopieën; de uitgevoerde berichtenproef is vastgelegd met haar werkelijke uitkomst.
Post-its toevoegen, bewerken, verplaatsen en verwijderen zonder een nieuwe softwarepublicatie. Afgeronde kaartjes hebben een apart veld voor handmatig geregistreerde afronding en testbewijs. Alleen afgeronde kaartjes van oudere releases worden gearchiveerd; kaartjes voor 0.2 blijven zichtbaar terwijl het bord nog op 0.1 staat.
Bevestigd: op 13 oktober zijn toevoegen, bewerken, status wijzigen, bewaren na verversen, archiveren en verwijderen handmatig gecontroleerd. De aangepaste archiefregel is eveneens bevestigd.
De ontwerpdocumentatie beschrijft de keten van limiet aanpassen via de API naar honderd JMeter-inzendingen, opslagcontrole en herstel. De proef accepteerde en bewaarde 88 berichten; 12 aanvragen werden begrensd met HTTP 429. De limiet is teruggezet naar 10.
Betekenis: het vastleggen van de proef is afgerond. Het doel van honderd geaccepteerde berichten is niet gehaald; die beperking blijft expliciet in het ontwerp staan.
Na publicatie worden bereikbaarheid, de SHA-256-bronvingerafdruk, het versielabel en belangrijke homepageonderdelen gecontroleerd. Het JSON-bewijs wordt lokaal bij de publicatieback-up bewaard.
Bevestigd: de eerste productie-uitvoering op 13 oktober meldde alle veertien controles geslaagd. Dit is een beperkte HTTP-controle en geen volledige functionele of beveiligingscontrole.
De zes lokale externe scripts krijgen via een gedeelde PHP-helper een SHA-256-inhoudsversie in hun URL. Gewijzigde inhoud levert een nieuwe URL op, zodat de browser bij opnieuw ophalen de actuele scriptversie kan laden.
Bevestigd: het ontwikkelbord gebruikte na deze aanpassing de actuele archiefregel. De aangeleverde afmelding vraagt nog om een eindcontrole van de werking van alle zes scripts; die volledige controle wordt hier niet als uitgevoerd gepresenteerd.
Vier disciplines zijn standaard ingeklapt; testbewaking heeft een eigen statuspaneel. Een startroute, bewijslabels en compacte begripsuitleg helpen bezoekers kiezen en begrijpen wat de acht projecten laten zien.
Bewijsgrens: de aangeleverde afmelding bevat nog een invulinstructie voor navigatie, openklappen, projectbediening en mobiele weergave. De wijziging is beschreven, maar die volledige handmatige eindcontrole is hiermee niet aangetoond.
De geplande laptoptest en lokale releasecontrole gebruiken de bron onder WebsiteOntwikkeling/tests. De lokale controle gebruikt een Git-snapshot; de geplande taak leest de actuele laptopbron. Doel-URL’s en resultatenmappen blijven gescheiden.
Bevestigd: de aangepaste laptoprunner is op 13 oktober succesvol uitgevoerd. De beheerregistratie en ontwerpdocumentatie zijn bijgewerkt.
Een extra CMD voert na geslaagde lokale tests automatisch de publicatie met back-up en online smoketest uit. Bij mislukte lokale tests start de publicatie niet. De losse test- en publicatiestappen blijven beschikbaar.
Bevestigd: de gecombineerde CMD is op 13 oktober uitgevoerd en de werking is bevestigd.
Versie 0.1 · In ontwikkeling
· Eerste overzicht van de huidige opzet
De broncode wordt lokaal beheerd met Git. Vóór publicatie draaien PHP-syntaxcontroles en geautomatiseerde browsertests. Alleen bij een passend testbewijs worden de geselecteerde bestanden naar de NAS gepubliceerd. SHA-256-vingerafdrukken controleren de bestanden en vooraf wordt een back-up gemaakt. Na publicatie blijft de bestaande testbewaking de online website en de NAW-service controleren.
Een openbare leerroute met twintig leerdoelen en zestig acceptatiecriteria verbindt mijn kennisontwikkeling aan de techniek van deze website. Mijn achtergrond in softwaretesten, testautomatisering, SQL, Python en Java vormt het vertrekpunt voor verdere verdieping in HTML, CSS, JavaScript, PHP en Git. In mijn portaal kan ik afgeronde toetsresultaten registreren en publiceren, met datum, score en toelichting. Deze resultaten zijn door mij geregistreerd en vormen geen onafhankelijke certificering. De toetsen zelf en automatische beoordeling zijn gepland voor versie 1.0.
Versie 0.2 staat live. De ontwikkelaar gaat nu offline. Morgen weer verder.